
Meta Data
- 发表时间:2026-08-10
- 作者:Zhengfeng Li, Lei Zhang, Xianwei Wu, Zhengqi Zhuang, Yingjie Xu, Boge Wang, Shaofei Zhu, Chuan Wang, Peng Zhao, Xinyu Zheng, Guoping Rong(阿里巴巴、南京大学、北京大学)
- 论文链接:https://arxiv.org/pdf/2608.09290.pdf
- arXiv 页面:https://arxiv.org/abs/2608.09290
- 项目链接:https://github.com/alibaba/open-code-review
OpenCodeReview:以确定性压过非确定性,实现低成本的基于 Agent 的代码评审
原文标题:OpenCodeReview: Determinism over Non-Determinism for Cost-Effective Agent-Based Code Review
Zhengfeng Li
阿里巴巴集团,杭州,浙江,中国
lizhengfeng.lzf@alibaba-inc.com
Lei Zhang
南京大学,南京,江苏,中国
602025320025@smail.nju.edu.cn
Xianwei Wu
南京大学,南京,江苏,中国
652024320006@smail.nju.edu.cn
Zhengqi Zhuang
南京大学,南京,江苏,中国
zephyrqz@163.com
Yingjie Xu
北京大学,北京,中国
xuyingjie@stu.pku.edu.cn
Boge Wang
阿里巴巴集团,杭州,浙江,中国
bogw.wbg@alibaba-inc.com
Shaofei Zhu
阿里巴巴集团,杭州,浙江,中国
zhushaofei.zsf@alibaba-inc.com
Chuan Wang
阿里巴巴集团,杭州,浙江,中国
nashui.wc@alibaba-inc.com
Peng Zhao
阿里巴巴集团,杭州,浙江,中国
zhuyun.zp@alibaba-inc.com
Xinyu Zheng
阿里巴巴集团,杭州,浙江,中国
yuxin.zxy@alibaba-inc.com
Guoping Rong
南京大学,南京,江苏,中国
ronggp@nju.edu.cn
图 1: OpenCodeReview 横幅。
摘要
基于 LLM 的代码评审 Agent 承诺可扩展、始终在线的评审,但当前系统存在两个交织的弱点:(1)非确定性——无界的工具使用与膨胀的动作空间使评审结果在多次运行间不稳定;(2)上下文局部性——评审者的有效访问仍被限制在 diff 本身,从而限制了可发现的问题深度。这两个弱点引出三项挑战:上下文检索错位,要么污染要么供给不足;将评审扩展到多文件 pull request 时的连贯性–效率权衡;以及幻觉评论侵蚀信任并带来核验成本。为应对这些挑战,我们提出 OpenCodeReview,这是一个基于 LLM 的代码评审 Agent,其原则是对不确定 Agent 做确定性工程:不是赋予 Agent 最大自由度,而是在评审流水线的三个刻意位置注入确定性。规则引导派发(Rule-Guided Dispatch) 使用多层规则系统确定性选择文件与评审标准,消除 Agent 驱动文件分诊的可变性。有根据的文件评审(Grounded File Review) 用一组经过策划、输出有界、通过 ReAct 循环暴露的评审专用工具替代自由探索,同时文件级并行 SubAgent 在上下文连贯性与执行效率之间取得平衡,并按需恢复跨文件依赖。独立反思(Independent Reflection) 在非对称信息边界下引入证伪优先的过滤器——反思器只看到 diff,看不到 Agent 经工具增强的探索——从而去除幻觉评论,同时避免内在自我批评的自我强化偏差,在保持 Recall 的同时提升 Precision。在 AACR-Bench(即 200 个真实世界 PR、10 种语言、1,505 条专家核验评论)上,OpenCodeReview 在六个 LLM 后端上持续优于主流编码 Agent(例如 Claude Code 与 Codex),SEM-F1 最高可达 $2.17times$(同一模型在 Claude Code 下为 25.10% vs. 11.57%),同时消耗的 token 少 $5text{–}15times$——表明深度、可靠性与效率可以同时达成。我们在 https://github.com/alibaba/open-code-review 开源 OpenCodeReview,以促进对基于 Agent 的代码评审进行确定性工程的进一步研究与采用。
CCS 概念: • 软件及其工程 $rightarrow$ 软件验证与确认;软件创建工具;• 计算方法 $rightarrow$ 人工智能;自然语言处理。
1 引言
代码评审是现代软件质量保证的基石,开发者通过它协作检查变更以检测缺陷、改善可维护性并传播知识 [1, 18]。然而人工评审的高成本——评审者时间、认知负荷与周转延迟——长期制约了其规模化采用:开发者将相当一部分时间花在评审上,大型项目中的 pull request 数量常常超过人力容量 [19]。这一张力推动了持续的评审过程自动化努力。
自动化代码评审旨在用提升评审效率与可扩展性的方法来增强或替代人类评审者 [12]。早期方法从静态检查器到基于学习的评论生成器,覆盖面与流畅度都有限。大语言模型(LLM)的迅速进展重塑了这一格局:它能以近乎为零的边际成本提供流畅的评审反馈,使可扩展、始终在线的评审者从长期愿望变为现实前景。因此,基于 LLM 的代码评审吸引了广泛关注,软件工程与 AI 顶级会议上的相关工作快速增长。
现有探索可分为三条路线:通过预训练或微调增强模型的评审能力 [6, 12, 13, 15],用检索到的上下文增强输入 [10, 32],以及将评审分解到多个 Agent [16, 22](第 2.1 节)。与此同时,工业界也拥抱了这一趋势:Claude Code1、Codex2、Cursor3 与 OpenCode4 等主流编码 Agent 现已内置代码评审,表明基于 LLM 的评审已从原型走向落地产品。
尽管有这些进展,听起来合理的反馈还不等于真正有用的反馈。一条有意义的评论必须在整个仓库的上下文中推理该变更(即它如何与调用者、被调用者、共享数据结构以及项目约定交互),而不是仅针对被改动的行。然而在所有三条路线中,评审者的有效上下文最终都被限制在 diff 及其周围(第 2.1 节),从而限制了可发现问题的深度:跨文件的控制流或数据流缺陷、破坏远端调用者的回归,以及仓库范围的约定违反,大多仍难以触及。新兴的基于 LLM 的 Agent 系统范式将推理、工具使用与多步探索交织在一起 [26](第 2.2 节),提供了一条打破该边界的路径:按需主动收集仓库级上下文,如自主程序修复与 issue 解决所示 [25, 31]。然而,将这一范式适配到代码评审会暴露三项耦合挑战。
第一,上下文检索的范围与策略仍是根本张力。 任意扩大上下文的 Agent 有用无关代码稀释信号的风险(即上下文污染),而检索过于保守的 Agent 会退回局部性受限的体制。现有 Agent 通常使用一套从程序修复或代码搜索借用的固定、手工设计的检索工具,其模式很少对照人类评审者如何在仓库中导航来验证 [29, 31],因此工具与评审的真实信息需求常常错位。一个诱人的补救是用通用 bash 工具进行自由仓库探索;这虽最大化了上下文收集自由度,但无界工具使用会用冗余输出膨胀上下文与 token 预算,巨大的动作空间引入显著非确定性,使评审结果在多次运行间远不稳定、难以复现 [4, 23, 24]。
第二,将基于 Agent 的评审扩展到多文件 pull request,会迫使在上下文连贯性与执行效率之间权衡。 单个整体 Agent 在一个共享上下文中评审整个变更集,能保留全局视图,但其成本随变更规模急剧增长,膨胀的上下文窗口也会稀释信号。另一极端是过细划分(例如按 hunk 或按函数评审),这最大化并行,但把一次连贯变更碎片化到孤立 Agent 中,膨胀协调开销并遮蔽变更整体。先前的多智能体系统要么采用中心化、会话式设计,其协调限制了可扩展性 [22],要么采用从开发工作流继承的角色分解,并不映射到评审 [8, 17]。如何选择既能保持变更连贯、又可处理地并行、并让每个评审者仍能恢复跨文件依赖的粒度,仍是开放问题。
第三,使 Agent 强大的自主性也使其不可靠。 多步 Agent 倾向于通过断言不存在的事实或捏造无支持的问题而产生幻觉,这种不稳定会在长 Agent 循环中累积 [11, 20]。在代码评审场景中,幻觉评论尤其有害:将真实发现与捏造发现交织的评审者会侵蚀信任,并带来可能抵消自动化本应节省成本的核验负担。现有缓解要么依赖内在自我反思,即同一模型批评自己的输出并继承相同偏差 [14, 20],要么依赖重量级程序分析验证器,它们只能核验窄类发现,无法裁定更广的语义评审评论 [5](第 2.3 节)。一种能跨不同类型拦截幻觉评论、同时不牺牲问题广度的机制仍然缺失。
为应对这些挑战,我们提出 OpenCodeReview,这是一个基于 LLM 的代码评审 Agent,其原则是对不确定 Agent 做确定性工程:不是赋予 Agent 最大自由度,而是在评审流水线的三个位置注入确定性,以确保所暴露问题的深度以及每条评论的可靠性。OpenCodeReview 围绕三项核心设计构建:
(1)规则引导派发(Rule-Guided Dispatch) 使用多层规则系统确定性选择文件与评审标准,消除 Agent 驱动文件分诊的可变性。不是让 Agent 决定哪些文件值得关注,规则驱动派发确保同一 PR 总是得到相同的文件与标准分配,为后续评审提供可复现的起点。
(2)有根据的文件评审(Grounded File Review) 用一组经过策划、输出有界、通过 ReAct 循环暴露的评审专用工具替代自由探索,同时文件级并行 SubAgent 在上下文连贯性与执行效率之间取得平衡,并按需恢复跨文件依赖。将工具设计建立在对专家评审者在真实 diff 上所用上下文检索模式的数据驱动分析之上,使 Agent 的信息收集与代码评审的真实需求对齐,从而发现深度的、跨越仓库的问题,同时保持检索上下文信息丰富且成本有界。
(3)独立反思(Independent Reflection) 在非对称信息边界下引入证伪优先的过滤器:反思器只看到 diff,看不到 Agent 经工具增强的探索,从而去除幻觉评论,同时避免内在自我批评的自我强化偏差 [14, 20]。按设计,反思器只过滤而不生成,在保持 Recall 的同时提升 Precision。
我们在 AACR-Bench [30] 上评测 OpenCodeReview。该基准是一个包含 200 个真实世界 PR 与 1,505 条专家核验评论的多语言基准。我们将其与六个 LLM 后端下的 Claude Code 与 Codex 比较。OpenCodeReview 在所有配置上取得最高 SEM-F1,最佳结果(Claude-4.6-Opus 下 25.10%)比同一模型在 Claude Code 下的 11.57% 高出 $2.17times$,同时将 token 消耗降低 $5text{–}15times$。这些结果确认:结构化的确定性工程能以显著更低的成本同时带来更深的评审与更高的可靠性。
总之,我们做出如下贡献:
(1)我们提出 OpenCodeReview,一个基于「对不确定 Agent 做确定性工程」原则的 LLM 代码评审 Agent,在评审流水线的三个位置注入确定性,以确保评审结果的深度与可靠性。
(2)我们在 AACR-Bench 上对六个 LLM 后端进行全面评测,表明 OpenCodeReview 持续优于主流编码 Agent,SEM-F1 最高可达 $2.17times$,token 少 $5text{–}15times$。
(3)我们开源 OpenCodeReview,以促进可复现性,并推动面向代码评审的确定性 Agent 设计研究。
2 背景与相关工作
本节综述激发 OpenCodeReview 的研究格局。我们首先回顾基于 LLM 的代码评审演进,然后覆盖面向软件工程的 LLM Agent,以及用于提升 Agent 可靠性的反思机制。
2.1 基于 LLM 的代码评审
现代代码评审是一种被广泛采用的实践,开发者检查 pull request(PR)以检测缺陷、改善可维护性并分享知识 [1, 18]。在 Google,代码评审被识别为开发者吞吐的主要瓶颈 [19],从而推动了持续的自动化努力。LLM 的迅速进展重塑了这一格局:它能以近乎为零的边际成本提供流畅评审反馈,使可扩展、始终在线的评审者从长期愿望变为现实前景。我们将基于 LLM 的代码评审方法沿三条路线组织:面向评审的模型训练、检索增强,以及 Agentic 代码评审。
面向评审的模型训练。 这条路线通过任务特定微调将 LLM 适配到代码评审。LLaMA-Reviewer [13] 及其后续工作 [6, 15] 在评审评论数据上微调开源 LLM,以改善评论生成质量。Yu 等人 [27] 进一步表明,微调可以同时增强所生成评论的准确性与可理解性。最近,MelcotCR [28] 提出一种最大熵调节的长思维链微调方法,训练 LLM 同时分析代码评审的多个维度,使 14B 模型达到与 671B 模型相当的表现。尽管有这些进展,评审知识最终被编码在模型权重中:推理时模型无法查阅目标仓库,仍被限制在 diff 上,限制了其暴露需要跨文件推理的问题的能力。
检索增强。 这条路线用检索到的上下文增强模型输入,以部分克服仅看 diff 的局部性。AUGER [3] 检索相似代码片段以播种评论生成。RAG-Reviewer [7] 通过对 top-$k$ 相似代码–评审对条件化,统一了生成方法与基于 IR 的方法,尤其改善了低频 token 的评论质量。LAURA [32] 用 PR 元数据、AST 扩展上下文,以及经 CodeT5+ embedding 检索的历史上相似评审来丰富输入。İçöz 与 Biricik [10] 通过上下文感知 RAG 流水线将评论建立在检索片段上。Sun 等人 [21] 系统比较了邻近、基于 LSP 的语义,以及基于 IR 的相似共变上下文,发现将问题列表评审与上下文增强结合可显著改善评审覆盖。尽管这些方法拓宽了有效上下文,它们只沿着检索器被设计的轴起作用:固定检索器无法自适应地追踪人类评审者所遵循的证据链(例如,「谁调用了这个被改动的函数,他们期望什么?」),也无法按其给定变更的信息需求调整策略。
Agentic 代码评审。 这条路线为代码评审采用基于 Agent 的范式。研究系统将评审分解为专门角色或带验证 Agent 的监督者–工作者设计 [16, 22]。工业界同时在主流编码 Agent 中交付了评审功能,包括 Cursor 的 BugBot、Claude Code、Codex 与 OpenCode,各自提供基于 diff 或沙箱 Agent 的评审,但没有专用上下文工具或多文件并行。一项针对 3,109 个 PR 的近期实证研究表明,仅由代码评审 Agent 完成的评审合并率为 45.2%(人工仅为 68.4%),被拒绝的仅 Agent PR 中有 60% 的信噪比低于 30% [2],这证明当前落地 Agent 产生了噪声、低质量的反馈。这些系统共有三项局限:(1)中心化协调限制可扩展性,单条会话线程无法高效处理大型多文件变更;(2)从开发工作流借用的角色分解(例如 coder、tester)与评审结构不对齐;(3)无一采用专用上下文工具,使 Agent 要么只依赖 diff,要么用通用、无界工具探索仓库。
为应对这些局限,我们提出 OpenCodeReview,一个基于「对不确定 Agent 做确定性工程」原则的 LLM 代码评审 Agent,具有三项核心设计:规则引导派发(确定性的文件与标准选择)、有根据的文件评审(策划的上下文工具与文件级并行 SubAgent),以及独立反思(基于证伪的评论过滤)。
2.2 面向软件工程的 LLM Agent
LLM Agent 将模型置于一个循环中:它推理状态、调用工具获得观察,并选择下一步动作;ReAct 范式 [26] 将其形式化为 Thought–Action–Observation 轨迹。软件工程是自然的应用领域:仓库是可查询环境,Agent 可以搜索定义、检查被调用者并运行分析以收集证据。这一洞见推动了缺陷修复与 issue 解决领域的迅速进展。SWE-agent [25] 通过定制的 Agent–计算机接口解决 GitHub issue,表明工具接口设计会实质影响性能。AutoCodeRover [31] 将修复分解为在一系列检索工具上的上下文检索与打补丁。RepoAudit [5] 审计仓库并用程序分析验证发现。ChatDev [17] 与 MetaGPT [8] 将开发组织为角色专门化的多智能体系统。
这些工作确认 Agent 能有效导航仓库,为我们为有根据的文件评审设计策划上下文工具提供了依据。然而,现有 Agent 系统在两个关键方面与代码评审不同,从而激发我们的文件级 SubAgent 划分:(1)其目标是产出修复或裁决,而评审必须发现并阐明问题,需要不同的工具与成功标准;(2)其组织依赖单个 Agent 或开发角色分解,二者都不自然适合多文件 PR 评审。我们的文件级划分专为评审构建,直接应对上下文连贯性与执行效率之间的连贯性–效率权衡。
2.3 Agent 可靠性与反思机制
LLM Agent 输出的不可靠源于两个来源:模型固有的幻觉,以及 Agent 工具使用轨迹引入的非确定性。二者都使自主评审在没有保障时不安全落地,并且各自需要不同的缓解策略。
关于幻觉,LLM Agent 倾向于断言无支持的事实,这种倾向会在长工具调用循环中累积 [11]。现有缓解分为两营:(1)内在自我反思(例如 Reflexion [20]、Self-Refine [14])让同一模型批评自己的输出,继承导致错误的偏差;(2)外部验证(例如 RepoAudit 的程序分析检查 [5])仅对分析器所核验的窄类事实可靠,无法裁定更广的语义评论。我们的独立反思模块通过将反思器与评审 Agent 解耦来应对幻觉,避免内在反思的自我强化偏差。通过只过滤、从不生成,它在不约束问题广度的情况下提升 Precision。
关于非确定性,bash 一类自由形式工具会膨胀上下文预算,产生「token 雪球」效应 [4, 23],巨大动作空间也在多次运行间引入可变性 [24],这促使我们在有根据的文件评审模块中采用策划的、评审专用的工具集,而不是自由探索。
3 OpenCodeReview Agent
3.1 概览
如第 2 节所确立,现有自动化代码评审方法存在两个交织的弱点:(1)非确定性,无界工具使用与膨胀动作空间使 Agent 行为在多次运行间不稳定 [4, 23, 24];(2)上下文局部性,评审者的有效访问最终被限制在 diff 及其周围,从而限制可发现问题的深度。这两个弱点在实践中相关:Agent 系统中流行的自由形式工具(例如通用 shell 访问)是非确定性的关键贡献者,而检索增强方法中占主导的固定检索器是上下文局部性的关键贡献者。根因是单一设计缺口:没有现有系统沿着对照代码评审真实信息需求验证过的轴来约束 Agent 行为。
OpenCodeReview 建立在我们称为对不确定 Agent 的确定性工程的设计哲学上。不是赋予 Agent 最大自由度并希望它收敛,我们在评审流水线的三个位置注入确定性,每一处应对第 2 节识别出的一种非确定性或局部性来源:
(1)规则引导派发 用多层规则系统替代临时文件选择,确定性决定评审哪些文件以及应用何种评审标准,消除 Agent 驱动文件分诊的非确定性。
(2)有根据的文件评审 用通过 ReAct 循环暴露的策划、评审专用工具集替代自由探索,将 Agent 的动作空间约束为既对评审有成效、又在上下文足迹上有界的操作,从而应对「token 雪球」效应 [4],同时打破局部性边界。
(3)独立反思 用在非对称信息边界下运作的外部证伪检查替代内在自我批评,过滤幻觉评论,同时避免同模型反思的自我强化偏差 [14, 20]。
这三个模块一起构成一条在派发上确定、在探索上有根据、在输出上可靠的流水线。图 2 展示了总体架构,本节其余部分详述每个模块。
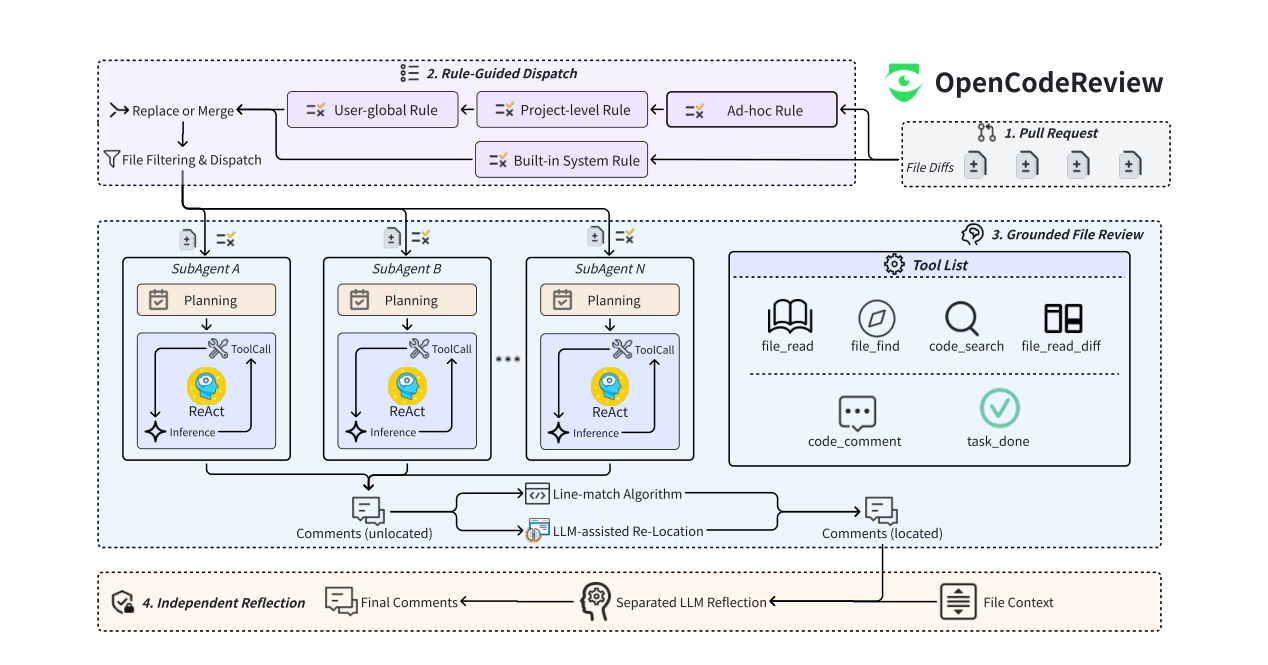
图 2: OpenCodeReview 概览。流水线分三阶段推进。(1)规则引导派发:给定一个 PR,系统从四层链(内置、用户全局、项目级与临时)为每个被改文件解析适用规则,按扩展名、用户包含/排除模式与规模过滤文件,并为每个文件并行派发一个 SubAgent。(2)有根据的文件评审:每个 SubAgent 用该文件的 diff、解析得到的规则以及策划工具集(file_read、file_find、code_search、file_read_diff、code_comment、task_done)执行 ReAct 循环,其有界输出防止上下文膨胀同时支持跨文件探索。生成的评论通过多阶段回退机制解析到精确行号。(3)独立反思:外部反思器在非对称信息边界下仅对照 diff 审查每条评论,过滤被 diff 证据直接反驳的评论,避免同模型批评的自我强化偏差。
3.2 规则引导派发
基于 Agent 的评审中非确定性的第一个来源是文件选择:当被要求「评审这个 PR」时,Agent 必须决定哪些文件值得关注以及应用何种标准。若留给 Agent,这一决策会在多次运行间变化,并可能忽略受项目特定评审标准约束的文件。OpenCodeReview 通过使文件选择与标准分配由规则驱动而非 Agent 驱动来消除这种可变性。
3.2.1 规则概念
OpenCodeReview 中的规则是一份自然语言文档,为一类文件指定评审标准。规则服务双重目的:它们决定哪些文件在范围内(通过基于 glob 的路径模式),以及 SubAgent 应检查什么(通过覆盖正确性、安全、性能、可维护性与测试覆盖的结构化评审清单)。每份规则文档是领域特定的。例如,面向静态类型语言的规则可包含线程安全与常见框架陷阱检查,而面向 CI 配置文件的规则聚焦工作流语法与密钥管理。这确保评审标准按文件类型量身定制,而不是通用的。
3.2.2 多层规则解析
规则被组织为四层优先级链(表 1),每一层对应不同的权威范围。
表 1: 四层规则优先级链。
| 层级 | 来源 | 范围 |
|---|---|---|
| 1(最高) | 调用时提供的临时规则 | 每次调用 |
| 2 | 存储在仓库中的项目级规则 | 项目特定、受版本控制 |
| 3 | 存储在用户主目录中的用户全局规则 | 跨项目 |
| 4(最低) | 内置系统规则 | 按语言/文件类型的默认 |
在基层,系统附带一组覆盖主要编程语言与配置文件格式的内置规则。路径匹配使用带花括号展开与大小写不敏感比较的递归 glob 模式,按声明顺序求值,采用先匹配者胜出的语义。这确保每个文件被确定性映射到最具体的适用规则。
当用户定义项目或全局规则时,它可以以两种模式之一与系统规则交互:
- 替换模式(默认): 用户规则对匹配路径完全取代系统规则。
- 合并模式: 系统规则与用户规则被拼接为单一文档,保留语言特定默认,同时追加项目特定标准。
这种分层设计确保评审标准是确定性的:同一 PR 总是得到相同的规则分配,同时仍可适应——项目可以覆盖或扩展默认,而无需修改系统。
3.2.3 文件过滤与派发
在派发 SubAgent 之前,OpenCodeReview 对被改文件应用多阶段过滤:(1)排除二进制文件;(2)若已配置,应用用户定义的排除模式;(3)若定义了包含模式,仅匹配文件通过;(4)内置扩展名允许列表过滤不支持的文件类型;(5)默认排除模式移除测试夹具与生成代码。此外,(6)diff 内容超过模型上下文窗口 80% 的文件被过滤,以避免上下文饱和。对每个剩余文件,系统通过四层链解析适用规则文本,并通过将文件 diff、解析得到的规则、其他被改文件列表以及任何用户提供的背景信息注入 prompt 模板来构造 SubAgent 的输入。随后每个 SubAgent 作为独立并发任务启动,从而实现文件级并行。
这一设计确保评审的「什么」(哪些文件)与「如何」(何种标准)完全由规则而非 Agent 裁量决定,消除运行间可变性的一个主要来源,同时保留适应项目约定的灵活性。
3.3 有根据的文件评审
一旦 SubAgent 带着文件的 diff 与适用规则被派发,它必须探索仓库以收集识别深层跨文件问题所需的上下文,同时避免自由形式工具的非确定性与上下文膨胀。OpenCodeReview 通过带策划工具集的基于 ReAct 的 Agent 循环实现这一点,旨在将 Agent 的推理建立在证据上,同时限制其上下文足迹。
3.3.1 Agent 循环
每个 SubAgent 遵循标准 ReAct 循环 [26]:在每次迭代中,LLM 产生一个思想(对当前状态的推理)并选择一个动作(一次工具调用);工具输出作为观察返回并追加到对话历史。循环持续直到 Agent 调用 task_done 或达到最大迭代上界。我们将默认上界设为 30,作为实用权衡:它足够高以容纳典型跨文件探索(例如追踪调用者、检查被调用者、查看相关测试),又足够低以作为防止失控循环的硬顶。另外两个控制机制进一步防止循环在达到该上界前退化:
- 空轮检测。 若 Agent 连续三轮不产生工具调用,则被提示采取行动或终止,防止无限停滞。
- 上下文压缩。 随着对话增长,OpenCodeReview 对照模型上下文窗口监视 token 使用。在 60% 利用率时触发异步后台压缩;在 80% 时,同步压缩强制将对话历史的中间区域总结为结构化摘要,同时保留系统 prompt 与最近交互。这一三区域策略(冻结–压缩–活跃)缓解 token 雪球效应 [4, 23]。
3.3.2 策划的上下文工具
不是暴露通用 bash shell——它以膨胀动作空间与上下文预算为代价最大化灵活性 [24]——OpenCodeReview 提供固定的六种评审专用工具,每种都有有界输出。表 2 汇总了该工具集。
表 2: 有根据的文件评审所用策划工具集。
| 工具 | 用途 | 有界输出 |
|---|---|---|
| file_read | 按路径以及可选行范围读取文件内容 | 每次调用最多 500 行 |
| file_find | 按名称关键字定位文件 | 最多 100 条结果 |
| code_search | 在仓库中搜索文本模式 | 最多 100 条匹配,10s 超时 |
| file_read_diff | 查看另一个被改文件的 diff | 返回预先计算的 diff |
| code_comment | 提交评审评论 | 异步解析并收集 |
| task_done | 发出任务完成信号 | 终止循环 |
这一工具集受到如下观察的激发:工具接口设计会实质影响 Agent 性能 [25]。每种工具对应人类评审者会满足的一种不同信息需求:阅读被改函数的完整上下文(file_read)、定位定义或测试(file_find)、追踪被改 API 的调用者(code_search)、理解一次变更如何与并发修改交互(file_read_diff),以及记录发现(code_comment)。其中,file_read_diff 对多文件 PR 设置是独特的,系统 prompt 中的严格聚焦规则指示 SubAgent:其他文件中的发现不得成为评论对象,因为只有当前文件的 diff 处于评审之下。
每种工具的有界输出是刻意约束:通过限制结果并强制超时,系统防止任何单次工具调用饱和上下文窗口,使 Agent 行为可预测且成本有界,同时不牺牲追踪跨文件依赖的能力。
3.3.3 评论生成与行定位
当 Agent 识别出一个问题时,它调用 code_comment,带上评论文本、用于定位的代码片段(existing_code),以及可选的建议修复(suggestion_code)。由于 Agent 可能产生不精确或不完整的代码片段,OpenCodeReview 通过三阶段回退解析行号,而不是直接信任 Agent 的输出。第一阶段,系统尝试将 existing_code 与 diff 的新侧 hunk 匹配,从而在被改区域内得到精确行锚点。若匹配失败,第二阶段搜索完整文件内容,处理片段引用 diff 之外未改行的情形。若两阶段都失败,第三阶段调用 LLM 辅助重定位步骤,从周围上下文重新抽取被引用片段。这一多阶段回退确保即使 Agent 的定位不可靠,评论也能被准确锚定。
3.4 独立反思
使 ReAct 循环有效的自主性,也使其容易产生幻觉:Agent 可能断言 diff 证据不支持或直接反驳的问题 [11]。如第 2.3 节所讨论,现有缓解要么依赖内在自我反思(继承相同偏差),要么依赖外部程序分析验证器(仅覆盖窄类事实类型)。OpenCodeReview 引入一种在信息边界上独立、在覆盖上宽广的反思机制。
3.4.1 非对称信息边界
反思模块在 SubAgent 完成其 ReAct 循环后被调用。它接收两个输入:文件的 diff 以及 SubAgent 产生的评论列表。关键的是,反思器在非对称信息边界下运作:与通过工具访问完整仓库的 SubAgent 不同,反思器只看到 diff。这一设计是刻意的。SubAgent 可能使用从其他文件收集的上下文形成评论,而这些上下文反思器无法核验。反思器不是试图重新推导该上下文,其任务被窄化:只过滤那些被 diff 本身中的证据直接反驳的评论。
这种非对称是该模块独立性的关键。内在自我反思之所以失败,是因为同一模型带着相同上下文审查自己的输出,倾向于确认其先前结论 [14, 20]。外部验证器之所以失败,是因为它们只覆盖程序分析器能检查的窄类事实。反思模块占据中间地带:它使用相同 LLM,但其信息边界不同。它看到的比 Agent 少,而不是更多,这打破了自我强化偏差,同时不把覆盖限制在可分析核验的事实类型上。
3.4.2 证伪,而非证实
反思器的指导原则是证伪而非证实,灵感来自认识论原则:主张应通过试图反驳而不是确认来检验 [9]。具体而言,反思器对每条评论执行两步评估:
- 事实检查(否决规则): 反思器检查 diff 是否包含对评论关键主张的直接反证。若 diff 与评论矛盾,该评论被标记为移除。若评论引用 diff 中不可见的上下文(例如其他文件中的逻辑、运行时行为),反思器不标记它,因为 SubAgent 可能从其工具增强探索中拥有有效证据。
- 问题分类: 对 diff 可见事实准确的评论,反思器检查评论是否误述代码,例如将明显正常的代码标为缺陷,或以与 diff 矛盾的方式归因行为。只有 diff 直接证明描述错误的评论才被标记。
这种证伪优先设计有两个后果。第一,它保持 Recall:反思器无法证伪的评论被保留,即使可疑,因为 SubAgent 可能拥有反思器所缺的证据。第二,它提升 Precision:被 diff 证据直接反驳的评论——最有害的幻觉类型——被移除。因此该模块作为高精度、保守的过滤器运作,而不是激进的再评审者。
3.4.3 仅过滤设计
反思模块严格是过滤器:它可以移除评论但不能生成新评论。这一设计选择确保该模块的影响始终是保守的:对一组评论进行反思只能减少假阳性,绝不会引入新的假阳性。若 LLM 的响应无法解析,该模块失败开放:保留全部评论,在失败情形下优先 Recall 而非 Precision。
这种仅过滤设计将 OpenCodeReview 与两类系统区分开:Reflexion 风格系统中反思器可能改写输出,以及产生自身发现的程序分析验证器。通过将反思器限制为删除,系统确保所暴露问题的广度仅由 SubAgent 的探索决定,而每条被暴露评论的可靠性被独立检查。
4 评测
为评估 OpenCodeReview 的确定性工程哲学是否转化为具体性能增益,我们在 AACR-Bench [30] 上评测它。AACR-Bench 是最近引入的面向自动化代码评审的多语言、仓库级基准。我们与两个内置评审功能的主流编码 Agent 比较:Claude Code 与 Codex。
4.1 评测设置
4.1.1 基准与指标
我们在 AACR-Bench [30] 上评测。该基准是一个多语言、仓库级基准,包含来自 50 个开源仓库、跨越 10 种编程语言的 200 个真实世界 pull request。Ground Truth 由 1,505 条评审评论构成,这些评论通过「AI 辅助、专家核验」流水线,经 80 余名高级工程师三轮交叉验证。与仅提供 diff 级上下文或依赖噪声原始 PR 评论的先前基准不同,AACR-Bench 为跨文件探索保留完整仓库结构,并提供专家核验标注,为评测代码评审系统提供可靠基础。
AACR-Bench 通过语义匹配评测生成评论:不是精确字符串匹配,评测流水线判断一条生成评论是否在同一代码位置表达与 Ground Truth 评论相同的关切。语义等价由 LLM 评判器决定(本文使用 Qwen3-235B-A22B-Instruct)。基于所得匹配,基准计算 Precision(语义匹配 Ground Truth 的生成评论比例)、Recall(被匹配的 Ground Truth 评论比例),以及作为主要排序指标的 SEM-F1(二者调和平均)。
4.1.2 系统与模型
我们评测三个代码评审系统:
- OpenCodeReview(v1.3.1): 我们的系统,配置默认规则集、策划工具集与独立反思模块。
- Claude Code(v2.1.169,
/code-review命令): Anthropic 的编码 Agent,带内置评审功能。它采用通用 Agent 循环,没有评审专用工具或文件级并行。 - Codex(v0.140.0,
/review命令): OpenAI 的编码 Agent,带沙箱仓库访问,使用单 Agent 评审循环。
每个系统用多个 LLM 后端评测,以将系统设计与模型能力解耦:OpenCodeReview 用全部六个模型评测(Claude-4.6-Opus、Claude-4.8-Opus、GPT-5.5、GLM-5.1、Qwen3.7-Max 与 Deepseek-V4-Pro);Claude Code 用六个模型评测,排除 GPT-5.5;Codex 仅用 GPT-5.5 评测,原因是模型兼容性与评测成本约束。所有系统共享相同的 LLM 配置,确保观察到的性能差异反映系统设计而非模型优势。
4.2 总体结果
表 3 给出完整结果。OpenCodeReview 在全部六个 LLM 后端上取得最高 SEM-F1,最佳配置(Claude-4.6-Opus)达到 25.10% SEM-F1、33.90% Precision 与 20.00% Recall。同一模型后端在 Claude Code 下仅达到 11.57% SEM-F1,不到 OpenCodeReview 分数的一半;在 Codex 下,GPT-5.5 仅达到 8.36%。结果中浮现两种模式:
(1)OpenCodeReview 在所有模型后端上持续优于两个基线。 在所有测试配置中,OpenCodeReview 的 SEM-F1 范围为 17.90% 到 25.10%,而 Claude Code 为 10.93%–14.13%,Codex 为 8.36%。值得注意的是,在 OpenCodeReview 下排名第一的模型(Claude-4.6-Opus,25.10%)在 Claude Code 下接近垫底(11.57%),这是仅可归因于系统设计的 $2.17times$ 改进。即使最弱的 OpenCodeReview 配置(Deepseek-V4-Pro,17.90%)也超过最强的 Claude Code 配置(14.13%),表明性能差距对模型选择是稳健的。
(2)性能优势源于 Precision,而非 Recall 膨胀。 OpenCodeReview 的 Precision 范围为 25.20% 到 37.80%,而 Claude Code 为 7.23%–15.93%,Codex 为 27.82%。Claude Code 通过生成大量评论达到其最高 Recall(28.90%)——200 个 PR 上 4,580 条,而 OpenCodeReview 为 465–1,096 条——但以严重的 Precision 下降(7.23%)为代价。这种模式,即 Agent 通过发出许多低置信评论来补偿浅层分析,正是先前关于落地代码评审 Agent 的工作所记录的「低信噪比」问题 [2]。OpenCodeReview 的独立反思模块抑制这种行为:通过过滤被 diff 证据直接反驳的评论,它在不牺牲问题广度的情况下保持高 Precision。
表 3: AACR-Bench 上的主要结果。粗体值表示每个模型组(行)在各指标上的最佳结果。OpenCodeReview 在所有模型后端上取得最高 SEM-F1,并在 Precision、token 效率与评审时间上具有一致优势。Avg. Token 与 Avg. Time 分别表示每个样本的平均 token 消耗与执行时间。Match/Gen 给出 Precision 的匹配/生成计数;Match/GT 给出 Recall 的匹配/Ground Truth 计数。Ground Truth 包含 1,505 条评论。
| 模型 | 系统 | SEM-F1 | Prec. | Match/Gen | Recall | Match/GT | Avg. Token | Avg. Time |
|---|---|---|---|---|---|---|---|---|
| Claude-4.6-Opus | OpenCodeReview | 25.10% | 33.90% | 301/889 | 20.00% | 301/1505 | 385K | 1m23s |
| Claude Code | 11.57% | 7.23% | 435/5980 | 28.90% | 435/1505 | 5,664K | 13m06s | |
| Qwen3.7-Max | OpenCodeReview | 21.20% | 25.20% | 276/1096 | 18.30% | 276/1505 | 625K | 4m41s |
| Claude Code | 12.17% | 8.23% | 351/4260 | 23.37% | 351/1505 | 5,153K | 8m06s | |
| GPT-5.5 | OpenCodeReview | 21.00% | 32.10% | 234/728 | 15.50% | 234/1505 | 422K | 2m51s |
| Codex | 8.36% | 27.82% | 74/266 | 4.92% | 74/1505 | 525K | 2m58s | |
| Claude-4.8-Opus | OpenCodeReview | 17.90% | 37.80% | 176/465 | 11.70% | 176/1505 | 352K | 1m06s |
| Claude Code | 14.13% | 15.93% | 191/1200 | 12.70% | 191/1505 | 2,062K | 5m38s | |
| Deepseek-V4-Pro | OpenCodeReview | 17.90% | 30.60% | 191/624 | 12.70% | 191/1505 | 394K | 6m28s |
| Claude Code | 10.93% | 8.27% | 243/2945 | 16.13% | 243/1505 | 5,450K | 14m24s | |
| GLM-5.1 | OpenCodeReview | 20.40% | 28.90% | 237/820 | 15.70% | 237/1505 | 743K | 4m11s |
| Claude Code | 11.93% | 8.37% | 313/3742 | 20.80% | 313/1505 | 4,038K | 14m10s |
4.3 成本效率
本工作的中心主张是:确定性工程以更低成本取得更好结果。表 3 也通过比较使用相同或可比模型后端的系统之间的 token 消耗来隔离这一维度。
结果毫不含糊:OpenCodeReview 消耗的 token 比 Claude Code 少 $5text{–}15times$,同时 SEM-F1 高 $1.3text{–}2.2times$。token 节省直接来自三项确定性工程决策:(1)规则引导派发避免 Agent 驱动文件分诊的探索开销;(2)有界输出的策划工具防止自由形式 Agent 循环中膨胀上下文的「token 雪球」效应 [4];(3)带每文件上下文隔离的文件级并行避免中心化 Agent 所累积的整体上下文窗口。相对 Codex,OpenCodeReview 以可比 token 成本取得 $2.5times$ 更高的 SEM-F1。Codex 作为带通用仓库访问的单 Agent 循环运作,这可能限制其暴露深层跨文件问题的能力。
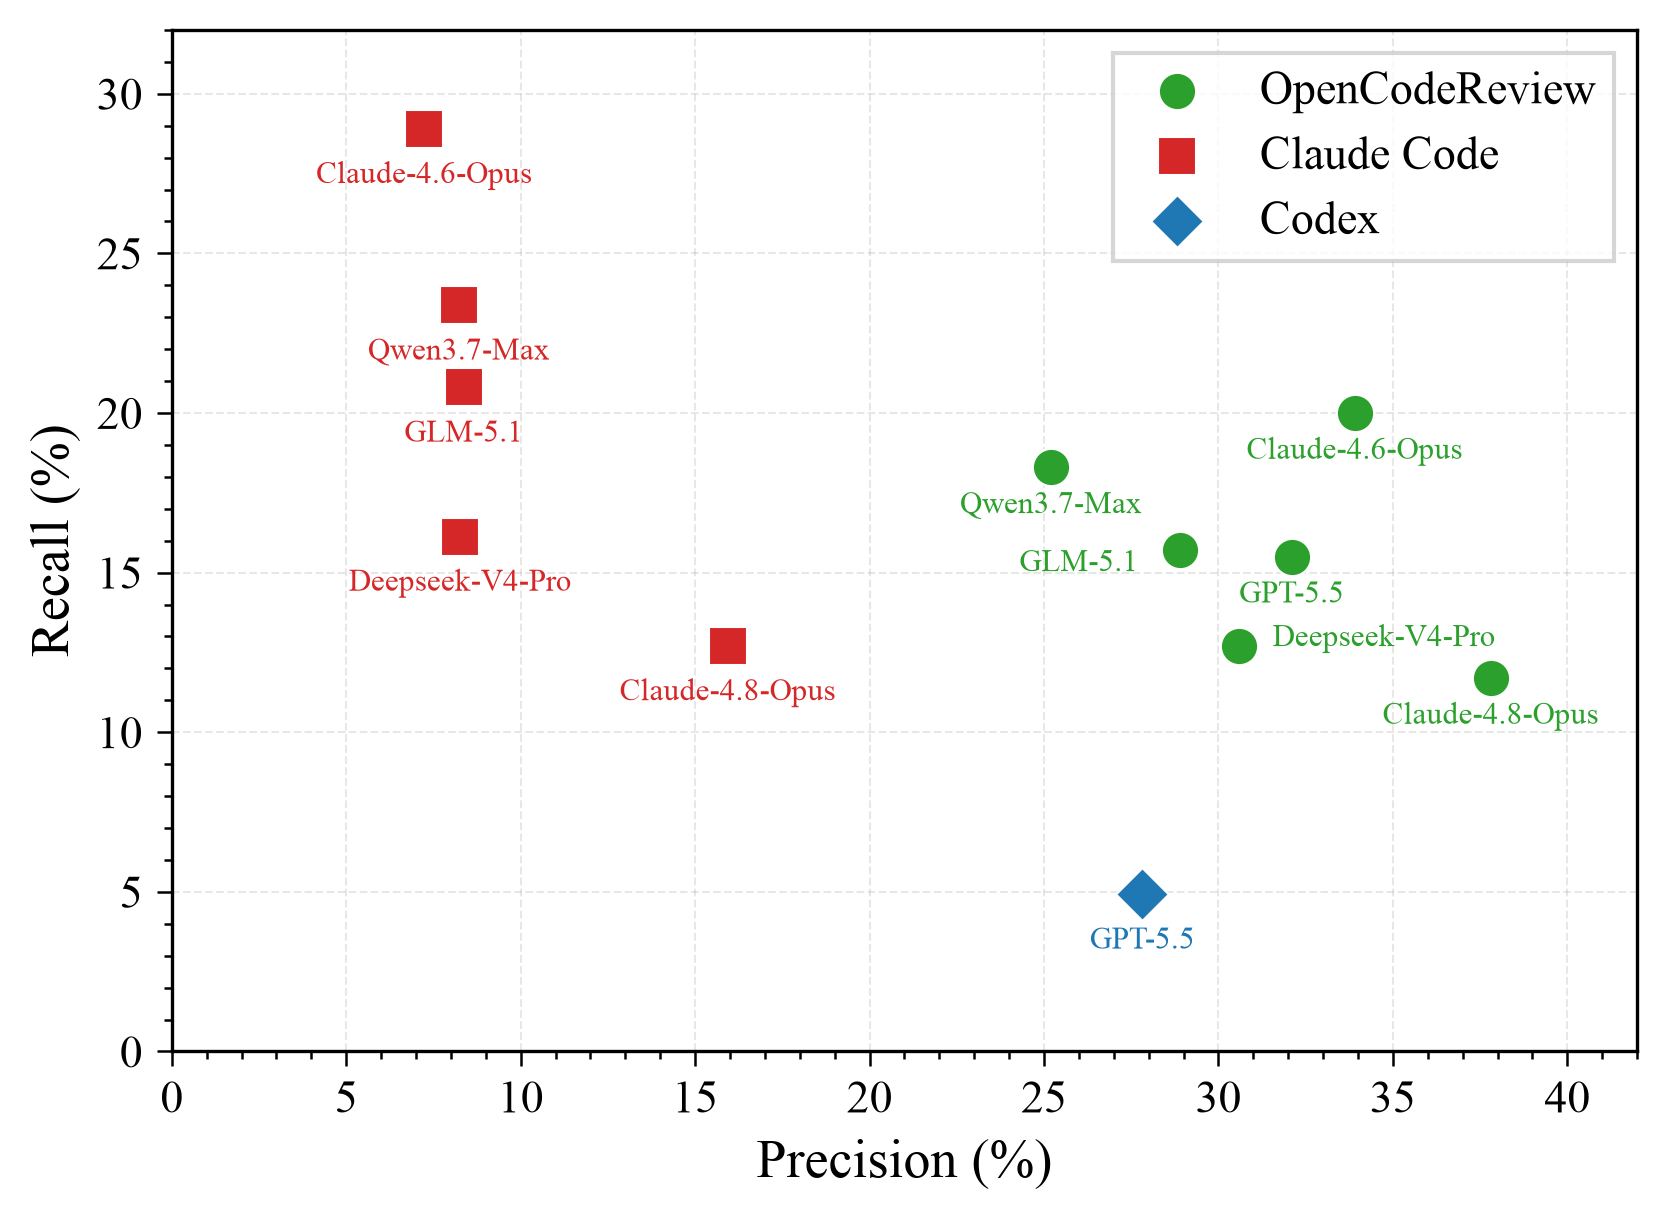
图 3: 全部 12 个配置的 Precision–Recall 权衡。OpenCodeReview 配置聚集在高 Precision、中等 Recall 区域,而 Claude Code 与 Codex 占据 Precision 更低、Recall 相当或更低的不同体制。
4.4 Precision–Recall 分析
Precision–Recall 权衡是自动化代码评审中的中心张力:激进系统暴露许多问题(高 Recall),代价是假阳性(低 Precision);保守系统生成少量但准确的评论(高 Precision),风险是错过真实问题(低 Recall)。图 3 在该空间中绘制全部 12 个配置。
OpenCodeReview 配置聚集在高 Precision、中等 Recall 区域(Precision 25–38%,Recall 12–20%)。Claude Code 配置分成两种体制:Claude-4.6-Opus 与 Qwen3.7-Max 变体达到高 Recall(23–29%)但 Precision 极低(7–8%),而 Claude-4.8-Opus 以低 Recall(13%)达到中等 Precision(16%)。Codex 占据第三种体制:极低 Recall(5%)与中等 Precision(28%),表明它生成少量但相对准确的评论——很可能因为它的单 Agent 循环在大多数 PR 上较早终止。
OpenCodeReview 在这一权衡中的有利位置是独立反思模块的直接后果。反思模块的证伪优先设计——只过滤被 diff 证据直接反驳的评论——优先移除假阳性,而不抑制引用 diff 之外上下文的真阳性。这解释了为何即使在基准上生成 700–1,100 条评论时 OpenCodeReview 仍将 Precision 保持在 25% 以上,而 Claude Code 在相似或更高生成量下 Precision 降至 7–8%。
5 讨论
评测表明,OpenCodeReview 的确定性工程——策划工具、文件级并行与独立反思——以主流编码 Agent 成本的一小部分,持续带来更好的评审质量。在具体数字之外,浮现出三项更广的洞见:
(1)确定性作为设计原则。 LLM Agent 研究中的流行假设是:更多自主性带来更好结果。我们的结果挑战这一点:OpenCodeReview 在三个层面刻意约束 Agent——文件选择、动作空间与输出可靠性——却在所有模型后端上优于约束更少的 Agent。这与先前发现共鸣:工具接口设计实质影响性能 [25],无界探索导致「token 雪球」效应 [4],巨大动作空间引入非确定性 [24]。对代码评审这类范围明确、重复性高的任务,非确定性不是 LLM Agent 的固有属性,而是可以通过沿着任务验证过的轴约束动作空间而被工程化消除的设计失败。
(2)反思的信息边界 vs. 模型边界。 反思模块通过非对称信息边界而非不同模型实现独立性。与 Reflexion [20] 和 Self-Refine [14] 使用同一模型、同一上下文(继承自我强化偏差),或外部验证器 [5] 仅覆盖窄类事实类型不同,OpenCodeReview 的反思器使用相同 LLM,但上下文更少(即只看 diff),并应用证伪优先原则。其有效性(六个后端上 Precision 25–38%)表明,对反思而言,信息边界可能比模型身份更重要;这一原则可能推广到输出可以对照证据子集检查的其他 Agent 任务。
(3)成本–质量前沿。 相对 Claude Code 的 $5text{–}15times$ token 节省来自结构化探索,而不是取消探索:规则引导派发避免浪费的文件分诊,有界工具限制每次调用的上下文增长,文件级并行防止整体上下文累积——同时不牺牲追踪跨文件依赖的能力。在工业规模上,评审是主要瓶颈 [19],这种成本降低将基于 Agent 的评审从溢价功能转变为可行默认,表明 LLM Agent 的成本–质量前沿不是固定的,而可以通过刻意工程向内推移。
6 效度威胁
内部效度。 基于 LLM 的 Agent 系统本质上是非确定性的 [24]。OpenCodeReview 通过三项设计决策缓解这一点——规则引导派发、有根据的文件评审与独立反思——每一项在流水线的不同位置注入确定性。所有系统进一步在相同采样参数下评测。一个相关威胁涉及指标计算中用于语义匹配的 LLM 评判器。为缓解评判器非确定性,我们对每个配置运行评判器五次,并报告均值指标作为最终结果。由于所有系统由同一匹配器在同一协议下评测,相对比较仍然有效。
外部效度。 尽管 AACR-Bench 无法覆盖所有工业代码库——尤其是领域特定语言或具有非常规结构的仓库——其对 10 种编程语言与 50 个仓库的覆盖为评测代码评审 Agent 提供了有代表性的多样性。为进一步增强可推广性,我们跨越四个提供商的六个 LLM 后端进行评测。尽管只比较了两个基线(Claude Code 与 Codex),二者都代表当前工业交付、带内置评审功能的编码 Agent 的最先进水平,确保观察到的结果可靠且有意义。
构念效度。 SEM-F1 作为语义匹配指标,可能无法完全刻画评审评论的实践价值:可操作性、清晰度与严重性等因素未被测量。相反,一条真正有用但与任何 Ground Truth 项都不匹配的评论会被计为假阳性。为缓解这一点,我们采用 AACR-Bench 的专家核验 Ground Truth,它经 80 余名高级工程师三轮交叉验证,实质降低了遗漏真实问题的可能性。
7 结论
我们提出了 OpenCodeReview,一个基于「对不确定 Agent 做确定性工程」原则的 LLM 代码评审 Agent。OpenCodeReview 在三个刻意位置注入确定性:规则引导派发(用于文件与标准选择的多层规则系统)、有根据的文件评审(带有界输出的策划工具集,用于受约束的探索),以及独立反思(带非对称信息边界与证伪优先原则的独立反思模块)。
在 AACR-Bench 上,OpenCodeReview 在六个 LLM 后端上持续优于主流编码 Agent,SEM-F1 最高可达 $2.17times$,同时消耗的 token 少 $5text{–}15times$。评测确认:系统设计对评审质量的贡献大于模型选择;结构化探索同时取得更好质量与更低成本;反思中的独立性可以通过信息边界而非模型身份实现。
展望未来,我们看到两个有前景的方向:从历史评审数据中自动发现规则以减少人工维护,以及将非对称信息边界原则推广到输出可以对照证据子集部分核验的其他 Agent 任务。我们希望 OpenCodeReview 的开源发布及其确定性工程哲学,有助于使基于 LLM 的代码评审对真实世界落地既可靠又经济。
参考文献
[1] Alberto Bacchelli and Christian Bird. 2013. Expectations, Outcomes, and Challenges of Modern Code Review. In Proceedings of the 35th International Conference on Software Engineering (ICSE). 712–721.
[2] Kowshik Chowdhury, Dipayan Banik, K M Ferdous, and Shazibul Islam Shamim. 2026. From Industry Claims to Empirical Reality: An Empirical Study of Code Review Agents in Pull Requests. In Proceedings of the 23rd International Conference on Mining Software Repositories (MSR).
[3] Xueying Du, Han Wu, Xiaobing Sun, Jingzhi Gong, Yu Zhang, and Xin Ye. 2022. AUGER: Automatically Generating Review Comments with Pre-trained Models. In Proceedings of the 30th ACM Joint European Software Engineering Conference and Symposium on the Foundations of Software Engineering (ESEC/FSE). 1442–1454.
[4] Zhiyu Fan, Kirill Vasilevski, Dayi Lin, Boyuan Chen, Yihao Chen, Zhiqing Zhong, Jie M. Zhang, Pinjia He, and Ahmed E. Hassan. 2025. SWE-Effi: Re-Evaluating Software AI Agent System Effectiveness Under Resource Constraints. arXiv preprint arXiv:2509.09853 (2025).
[5] Jinyao Guo, Chengpeng Wang, Xiangzhe Xu, Zian Su, and Xiangyu Zhang. 2025. RepoAudit: An Autonomous LLM-Agent for Repository-Level Code Auditing. arXiv preprint arXiv:2501.18160 (2025).
[6] Md. Asif Haider, Ayesha Binte Mostofa, Sk. Sabit Bin Mosaddek, Anindya Iqbal, and Toufique Ahmed. 2024. Prompting and Fine-tuning Large Language Models for Automated Code Review Comment Generation. arXiv preprint arXiv:2411.10129 (2024).
[7] Hyunsun Hong and Jongmoon Baik. 2025. Retrieval-Augmented Code Review Comment Generation. arXiv preprint arXiv:2506.11591 (2025).
[8] Sirui Hong, Mingchen Zhuge, Jonathan Chen, Xiawu Zheng, Yuheng Cheng, Ceyao Zhang, Jinlin Wang, Zili Wang, Steven Ka Shing Yau, Zijuan Lin, Liyang Zhou, Chenyu Ran, Lingfeng Xiao, Chenglin Wu, and Schürmannand Josef. 2024. MetaGPT: Meta Programming for a Multi-Agent Collaborative Framework. In Proceedings of the 12th International Conference on Learning Representations (ICLR).
[9] Kexin Huang, Ying Jin, Ryan Li, Michael Y. Li, Emmanuel Candès, and Jure Leskovec. 2025. Automated Hypothesis Validation with Agentic Sequential Falsifications. arXiv preprint arXiv:2502.09858 (2025).
[10] Osman İçöz and Asaf Biricik. 2026. Context-Aware Code Review Automation: A Retrieval-Augmented Approach. Applied Sciences 16, 4 (2026), 1875.
[11] Ziwei Ji, Nayeon Lee, Rita Frieske, Tiezheng Yu, Dan Su, Yan Xu, Etsuko Ishii, Ye Jin Bang, Andrea Madotto, and Pascale Fung. 2023. Survey of Hallucination in Natural Language Generation. Comput. Surveys 55, 12 (2023), 1–38.
[12] Fang Liu, Ge Li, Yusi Fu, Fei Jin, Wenlin Liu, Xiangxin Tan, and Xin Xia. 2022. Automating Code Review Activities by Large-Scale Pre-training. In Proceedings of the 30th ACM Joint European Software Engineering Conference and Symposium on the Foundations of Software Engineering (ESEC/FSE). 1035–1047.
[13] Junyi Lu, Lei Yu, Xiaojia Li, Li Yang, and Chun Zuo. 2023. LLaMA-Reviewer: Advancing Code Review Automation with Large Language Models through Parameter-Efficient Fine-Tuning. In Proceedings of the 34th IEEE International Symposium on Software Reliability Engineering (ISSRE).
[14] Aman Madaan, Niket Tandon, Prakhar Gupta, Skyler Hallinan, Luyu Gao, Sarah Wiegreffe, Uri Alon, Nouha Dziri, Shrimai Prabhumoye, Yiming Yang, Shashank Gupta, Bodhisattwa Prasad Majumder, Katherine Hermann, Shayne Longpre, Stephen Pulman, Suhas Patil, Sharan Narang, Gagan Bansal, Colin Raffel, Adam Hsuan, Yair Carmon, Asli Celikyilmaz, and Ed H. Chi. 2023. Self-Refine: Iterative Refinement with Self-Feedback. In Advances in Neural Information Processing Systems (NeurIPS).
[15] Phattharawin Namprasert, Chanathip Thongtan, Pongsakorn Tantikitti, Vishnu Tudupala, Patanamon Thongtanunam, Alaknantha Surendra, Hao Li, and Narayan Rangaraj. 2024. Fine-Tuning Large Language Models to Improve Accuracy and Consistency of Code Review Comment Generation. ACM Transactions on Software Engineering and Methodology (2024). doi:10.1145/3695993.
[16] Sai Sharanarthi Polineni et al. 2025. Multi-Agent LLM Collaboration for Adaptive Code Review, Debugging, and Security Analysis. In 2025 International Conference on Mechatronics, Robotics and Artificial Intelligence (ICMRAI).
[17] Chen Qian, Xin Cong, Wei Liu, Cheng Yang, Weize Chen, Yusheng Su, Yufan Dang, Jiahao Li, Juyuan Xu, Dahai Li, Zhiyuan Liu, and Maosong Sun. 2024. ChatDev: Communicative Agents for Software Development. In Proceedings of the 41st International Conference on Machine Learning (ICML).
[18] Peter C. Rigby and Margaret-Anne Storey. 2013. Understanding Broadcast Based Peer Review on Open Source Software Projects. Empirical Software Engineering 18, 2 (2013), 225–261.
[19] Caitlin Sadowski, Emma Söderberg, Luke Church, Michal Sipko, and Alberto Bacchelli. 2018. Modern Code Review: A Case Study at Google. In Proceedings of the 40th International Conference on Software Engineering: Software Engineering in Practice (ICSE-SEIP). 181–190.
[20] Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. 2023. Reflexion: Language Agents with Verbal Reinforcement Learning. In Advances in Neural Information Processing Systems (NeurIPS).
[21] Kexin Sun, Yucong Guan, Jiaqi Sun, Hongyu Kuang, Guoping Rong, Dong Shao, He Zhang, Xiaoxing Ma, and Christoph Treude. 2026. Improving LLM-Based Go Code Review through Issue-List Generation and Context Augmentation. arXiv preprint arXiv:2606.01859 (2026).
[22] Xunzhu Tang, Kisub Kim, Yewei Song, Cedric Lothritz, Bei Li, Saad Ezzini, Haoye Tian, Jacques Klein, and Tegawendé F. Bissyandé. 2024. CodeAgent: Autonomous Communicative Agents for Code Review. In Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (EMNLP). 11279–11313.
[23] Ningning Wang, Xavier Hu, Pai Liu, He Zhu, Yue Hou, Heyuan Huang, Shengyu Zhang, Jian Yang, Jiaheng Liu, Ge Zhang, Changwang Zhang, Jun Wang, Yuchen Eleanor Jiang, and Wangchunshu Zhou. 2025. Efficient Agents: Building Effective Agents While Reducing Cost. arXiv preprint arXiv:2508.02694 (2025).
[24] Abel Yagubyan. 2026. How Consistent Are LLM Agents? Measuring Behavioral Reproducibility in Multi-Step Tool-Calling Pipelines. arXiv preprint arXiv:2605.28840 (2026).
[25] John Yang, Carlos E. Jimenez, Alexander Wettig, Kilian Lieret, Shunyu Yao, Karthik Narasimhan, and Ofir Press. 2025. SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering. In Proceedings of the 47th International Conference on Software Engineering (ICSE).
[26] Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan, and Yuan Cao. 2023. ReAct: Synergizing Reasoning and Acting in Language Models. In Proceedings of the 11th International Conference on Learning Representations (ICLR).
[27] Yongda Yu, Guoping Rong, Haifeng Shen, He Zhang, Dong Shao, Min Wang, Zhao Wei, Yong Xu, and Juhong Wang. 2025. Fine-Tuning Large Language Models to Improve Accuracy and Comprehensibility of Automated Code Review. ACM Transactions on Software Engineering Methodology 34, 1 (2025), 14:1–14:26.
[28] Yongda Yu, Guohao Shi, Xianwei Wu, Haochuan He, XueMing Gu, Qianqian Zhao, Kui Liu, Qiushi Wang, Zhao Tian, Haifeng Shen, and Guoping Rong. 2025. Fine-Tuning LLMs to Analyze Multiple Dimensions of Code Review: A Maximum Entropy Regulated Long Chain-of-Thought Approach. arXiv preprint arXiv:2509.21170 (2025).
[29] Fengji Zhang, Bei Chen, Yue Zhang, Jacky Keung, Jin Liu, Daoguang Zan, Yi Mao, Jian-Guang Lou, and Weizhu Chen. 2023. RepoCoder: Repository-Level Code Completion Through Iterative Retrieval and Generation. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing (EMNLP). 2471–2484.
[30] Lei Zhang, Yongda Yu, Minghui Yu, Xinxin Guo, Zhengqi Zhuang, Guoping Rong, Dong Shao, Haifeng Shen, Hongyu Kuang, Zhengfeng Li, Boge Wang, Guoan Zhang, Bangyu Xiang, and Xiaobin Xu. 2026. AACR-Bench: Evaluating Automatic Code Review with Holistic Repository-Level Context. arXiv preprint arXiv:2601.19494 (2026).
[31] Yuntong Zhang, Haifeng Ruan, Zhiyu Fan, and Abhik Roychoudhury. 2024. AutoCodeRover: Autonomous Program Improvement. In Proceedings of the 33rd ACM SIGSOFT International Symposium on Software Testing and Analysis (ISSTA).
[32] Yuxin Zhang, Yuxia Zhang, Zeyu Sun, Yanjie Jiang, and Hui Liu. 2025. LAURA: Enhancing Code Review Generation with Context-Enriched Retrieval-Augmented LLM. In Proceedings of the 40th IEEE/ACM International Conference on Automated Software Engineering (ASE).
Comments NOTHING