
Meta Data
- 发表时间:2026-01-30
- 作者:Lei Zhang, Yongda Yu, Minghui Yu, Xinxin Guo, Zhengqi Zhuang, Guoping Rong, Dong Shao, Haifeng Shen, Hongyu Kuang, Zhengfeng Li, Boge Wang, Guoan Zhang, Bangyu Xiang, Xiaobin Xu(南京大学、南十字星大学、阿里巴巴)
- 论文链接:https://arxiv.org/pdf/2601.19494.pdf
- arXiv 页面:https://arxiv.org/abs/2601.19494
- 项目链接:https://github.com/alibaba/aacr-bench
AACR-Bench:基于完整仓库级上下文的自动化代码评审评测
原文标题:AACR-Bench: Evaluating Automatic Code Review with Holistic Repository-Level Context
Lei Zhang*¹, Yongda Yu*¹, Minghui Yu¹, Xinxin Guo¹, Zhengqi Zhuang¹, Guoping Rong¹, Dong Shao¹, Haifeng Shen², Hongyu Kuang¹, Zhengfeng Li³, Boge Wang³, Guoan Zhang³, Bangyu Xiang³, Xiaobin Xu³
¹ 南京大学软件学院,南京,中国
² 南十字星大学(Southern Cross University),黄金海岸,澳大利亚
³ 阿里巴巴 TRE,杭州,中国
通讯作者:Guoping Rong(ronggp@nju.edu.cn),Zhengfeng Li(lizhengfeng.lzf@alibaba-inc.com)
预印本。2026 年 2 月 2 日。
* 同等贡献。
摘要
高质量评测基准对于将大语言模型(LLM)部署到特定应用领域至关重要。然而,现有自动化代码评审(Automated Code Review, ACR)基准存在两项关键局限:其一,依赖从原始 Pull Request(PR)评论中提取的噪声、不完整的 Ground Truth,从而限制了问题检测的覆盖范围;其二,仓库级上下文缺乏多语言支持,从而限制了评测结果的可推广性。为应对这些挑战,我们提出 AACR-Bench,这是一个在多种编程语言上提供完整跨文件上下文的综合性基准。与传统数据集不同,AACR-Bench 采用「AI 辅助、人类专家核验」的标注流水线,以发现原始 PR 中常被忽略的潜在缺陷,使问题覆盖率提升了 285%。在 AACR-Bench 上对主流 LLM 的广泛评测表明,由于数据限制,以往评估可能误判或仅部分刻画了模型能力。我们的工作为 ACR 评测建立了更严格的标准,并就基于 LLM 的 ACR 给出新的洞见:上下文的粒度/层级以及检索方法的选择会显著影响 ACR 性能,且这种影响随 LLM、编程语言以及 LLM 使用范式(例如是否采用 Agent 架构)而变化。评测集的代码、数据及其他产物见 Github1。
1 引言
如今,在大语言模型(LLM)的赋能下,自动化代码评审(ACR)技术已被广泛研究与采用 (Hou et al. 2024; Zhang et al. 2023)。借助 LLM 出色的理解能力,研究者探索了多种端到端生成评审评论的方法,例如 Tufano 等人提出的预训练模型方案、兼顾成本与性能的微调策略 (Lu et al. 2023),以及基于强化学习的优化机制 (Le et al. 2022)。最近,基于 Agent 的代码评审系统也开始出现 (Guo et al. 2025b; Ren et al. 2025)。
ACR 研究与落地的繁荣,加剧了对能够全面评估其性能的可信基准的需求。然而,当前评测框架仍存在关键局限,可概括为两个主要问题。
- 问题标注不完整。 总体而言,现有基准直接将真实历史 PR 中的原始评审评论作为 Ground Truth,导致数据集在问题覆盖上存在固有局限 (Liu et al. 2025; Khoshnoud et al. 2022)。这使得无法真实、忠实地刻画模型在真实代码评审场景中发现潜在问题的能力。
- 上下文范围受限。 许多代码缺陷本质上是跨文件的,评审系统需要访问仓库级上下文才能准确检测。尽管已有部分基准提供跨文件上下文感知 (Zeng et al. 2025; Guo et al. 2025a),但它们大多局限于单一编程语言(如 Python)。这种语言特定的关注不仅限制了评测发现的可推广性,还可能引入与该语言语言学特征绑定的结构性偏差。因此,这类基准无法充分代表当代软件开发的多语言现实。
这些不足共同削弱了当前 ACR 评测的可信度与覆盖范围,凸显了构建更全面、更可信基准的必要性。
为应对上述挑战,我们提出 AACR-Bench——一个支持仓库级上下文感知的多语言 ACR 基准。首先,针对现有数据集问题标注有限的问题,我们构建了高质量混合语料。除从 GitHub PR 中收集 391 条真实评审评论外,我们还纳入了大量人工问题标注:80 名高级软件工程师(每人具备 2 年以上工业经验)仔细审阅了由两套 ACR 系统在六个 LLM 上生成的 2,145 条评论。该标注策略显著提升了问题覆盖率,使 AACR-Bench 相比常规数据集能够更准确、更全面地评估模型发现潜在问题的能力。其次,针对上下文与语言多样性问题,AACR-Bench 提供完整的仓库级依赖信息,并广泛覆盖 10 种主流编程语言。完整的 AACR-Bench 数据集可在本文补充材料中获取,并将随后开源。
我们的主要贡献概括如下:
- 我们将多模型生成与大规模人工标注相结合,以提升问题覆盖率,从而建立更好的 Ground Truth 数据集。
- 我们提出 AACR-Bench,这是面向 LLM 赋能 ACR 任务的首个多语言、仓库级上下文感知基准。
- 我们基于 AACR-Bench 对主流 LLM 进行了全面实证评测,并揭示了关于主流 LLM 的 ACR 能力的新洞见。
2 相关工作
我们从两个关键维度定位本研究:基于大语言模型(LLM)的 ACR 现状,以及相应专用基准方法的演进格局。
2.1 基于 LLM 的自动化代码评审
LLM 的近期进展推动了自动化代码评审(ACR)研究的增长,方法涵盖若干类别。早期工作包括基于 T5 的 ACR (Tufano et al. 2022) 以及 CodeReviewer (Li et al. 2022),后者在大规模 diff–评论对上预训练。为提升效率,Llama-Reviewer (Lu et al. 2023) 采用参数高效微调(Parameter-Efficient Fine-Tuning),而 Sun 等人引入了通过迭代反馈实现模型持续演化的「数据飞轮」(Data Flywheel)(Sun et al. 2025; Yu et al. 2024a)。近期工作将模型与人类偏好对齐:Yu 等人 (Yu et al. 2024b) 使用 Kahneman–Tversky Optimization 以增强评审效用,Kapadnis 等人 (Kapadnis et al. 2025) 将静态分析与 Direct Preference Optimization 结合,以更好地检测潜在缺陷。为应对有限上下文,Zhang 等人 (Zhang et al. 2025) 应用检索增强生成(Retrieval-Augmented Generation)以纳入项目级语义。为进一步扩展推理深度,基于 Agent 的框架采用多智能体协作 (Ren et al. 2025; Li et al. 2025; Sharanarthi & Polineni 2025) 以及辩论等辩证交互 (Tang et al. 2024),以产生更全面、更客观的评审。
2.2 代码评审基准
基准对于界定 LLM 的能力边界并引导算法演进至关重要 (Jimenez et al. 2023)。在 ACR 中,多样化方法的迅速涌现凸显了对标准化基准的需求,以系统评估性能并指导后续优化。目前 ACR 基准仍处于萌芽阶段,相关工作可分为两类:单项研究附带的数据集,以及专用评测数据集。使用最广的附带数据集是 CodeReviewer (Li et al. 2022),被许多近期工作采用 (Lu et al. 2023; Yu et al. 2024a; Yu et al. 2024b; Kapadnis et al. 2025; Ren et al. 2025; Li et al. 2025)。然而,它仅提供 diff 级代码片段,缺少仓库级上下文,相对生产环境的真实性有限。少数研究 (Sun et al. 2025; Sharanarthi & Polineni 2025) 完全放弃静态数据集,仅依赖线上用户反馈。专用基准包括 SWR-Bench (Zeng et al. 2025)(源自 SWE-Bench 的 12 个 Python 项目)以及 CodeFuse-CR-Bench (Guo et al. 2025a)(70 个 Python 项目)。二者虽提供完整仓库上下文,但仅聚焦 Python,可推广性受限。ContextCRBench (Hu et al. 2025) 提升了语言多样性(90 个仓库、9 种语言),但将上下文限制在文件级,无法评估复杂缺陷所需的跨文件(即仓库级)推理。
受上述格局启发,本文引入首个兼具多语言与仓库级上下文的 ACR 评测数据集,即 AACR-Bench,旨在建立更贴近真实生产环境的基准。
3 AACR-Bench
3.1 AACR-Bench 概览
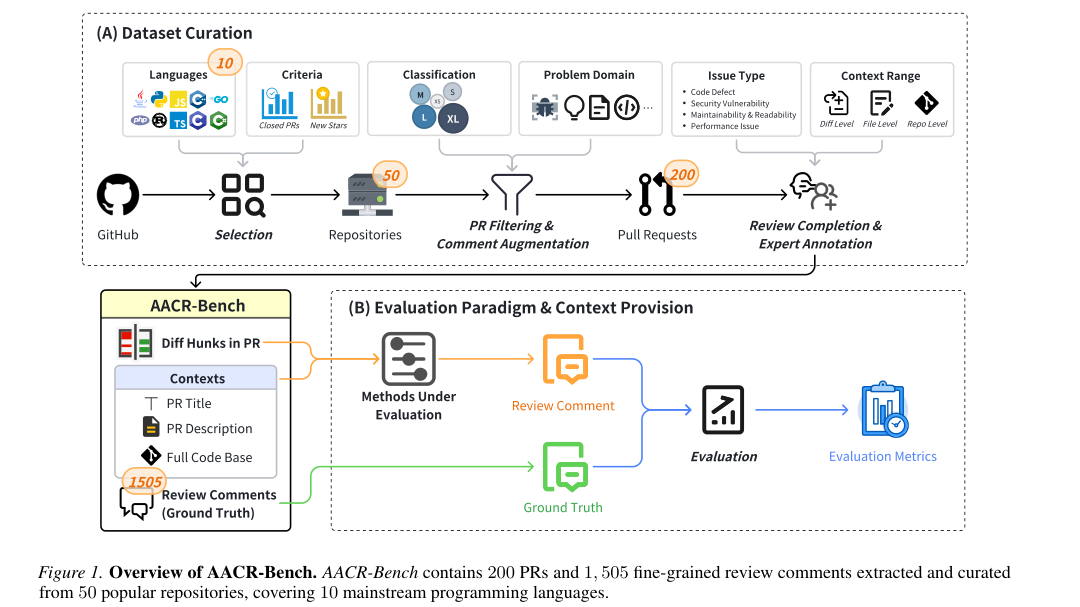
图 1: AACR-Bench 概览。AACR-Bench 包含从 50 个热门仓库提取并整理的 200 个 PR 与 1,505 条细粒度评审评论,覆盖 10 种主流编程语言。
AACR-Bench 是一个面向评测 ACR 方法/系统端到端性能的仓库级基准。图 1 展示了 AACR-Bench 的概览。总体而言,AACR-Bench 包含从 50 个热门仓库提取并整理的 200 个 PR 与 1,505 条细粒度评审评论,覆盖 10 种主流编程语言。此外,AACR-Bench 融合了模型增强的人工评审与完全由模型生成的评审,二者均经过人类专家标注的严格核验,以确保基准可信度。
表 1: 评审评论的上下文范围类别
| 上下文层级 | 描述 | 评论数 |
|---|---|---|
| Diff | 仅查看当前 diff hunk 即可给出的评审评论 | 754 |
| File | 需要包含该 diff hunk 的整个文件上下文的评审评论 | 518 |
| Repo | 需要仓库范围上下文的评审评论,包括 PR 元数据以及代码库中其他文件的内容 | 233 |
为与现代代码评审以 diff 为导向的范式对齐,AACR-Bench 将每个 PR 指定为一个评测单元。执行过程中,被评测的 ACR 方法遍历一个 PR 内的全部 diff Hunk 以生成评审评论。性能通过将这些生成评论与 Ground Truth(共 1,505 条)匹配,并计算特定准确率指标(例如 Precision、Recall 与 F1-score)来评估。
3.2 数据集构建
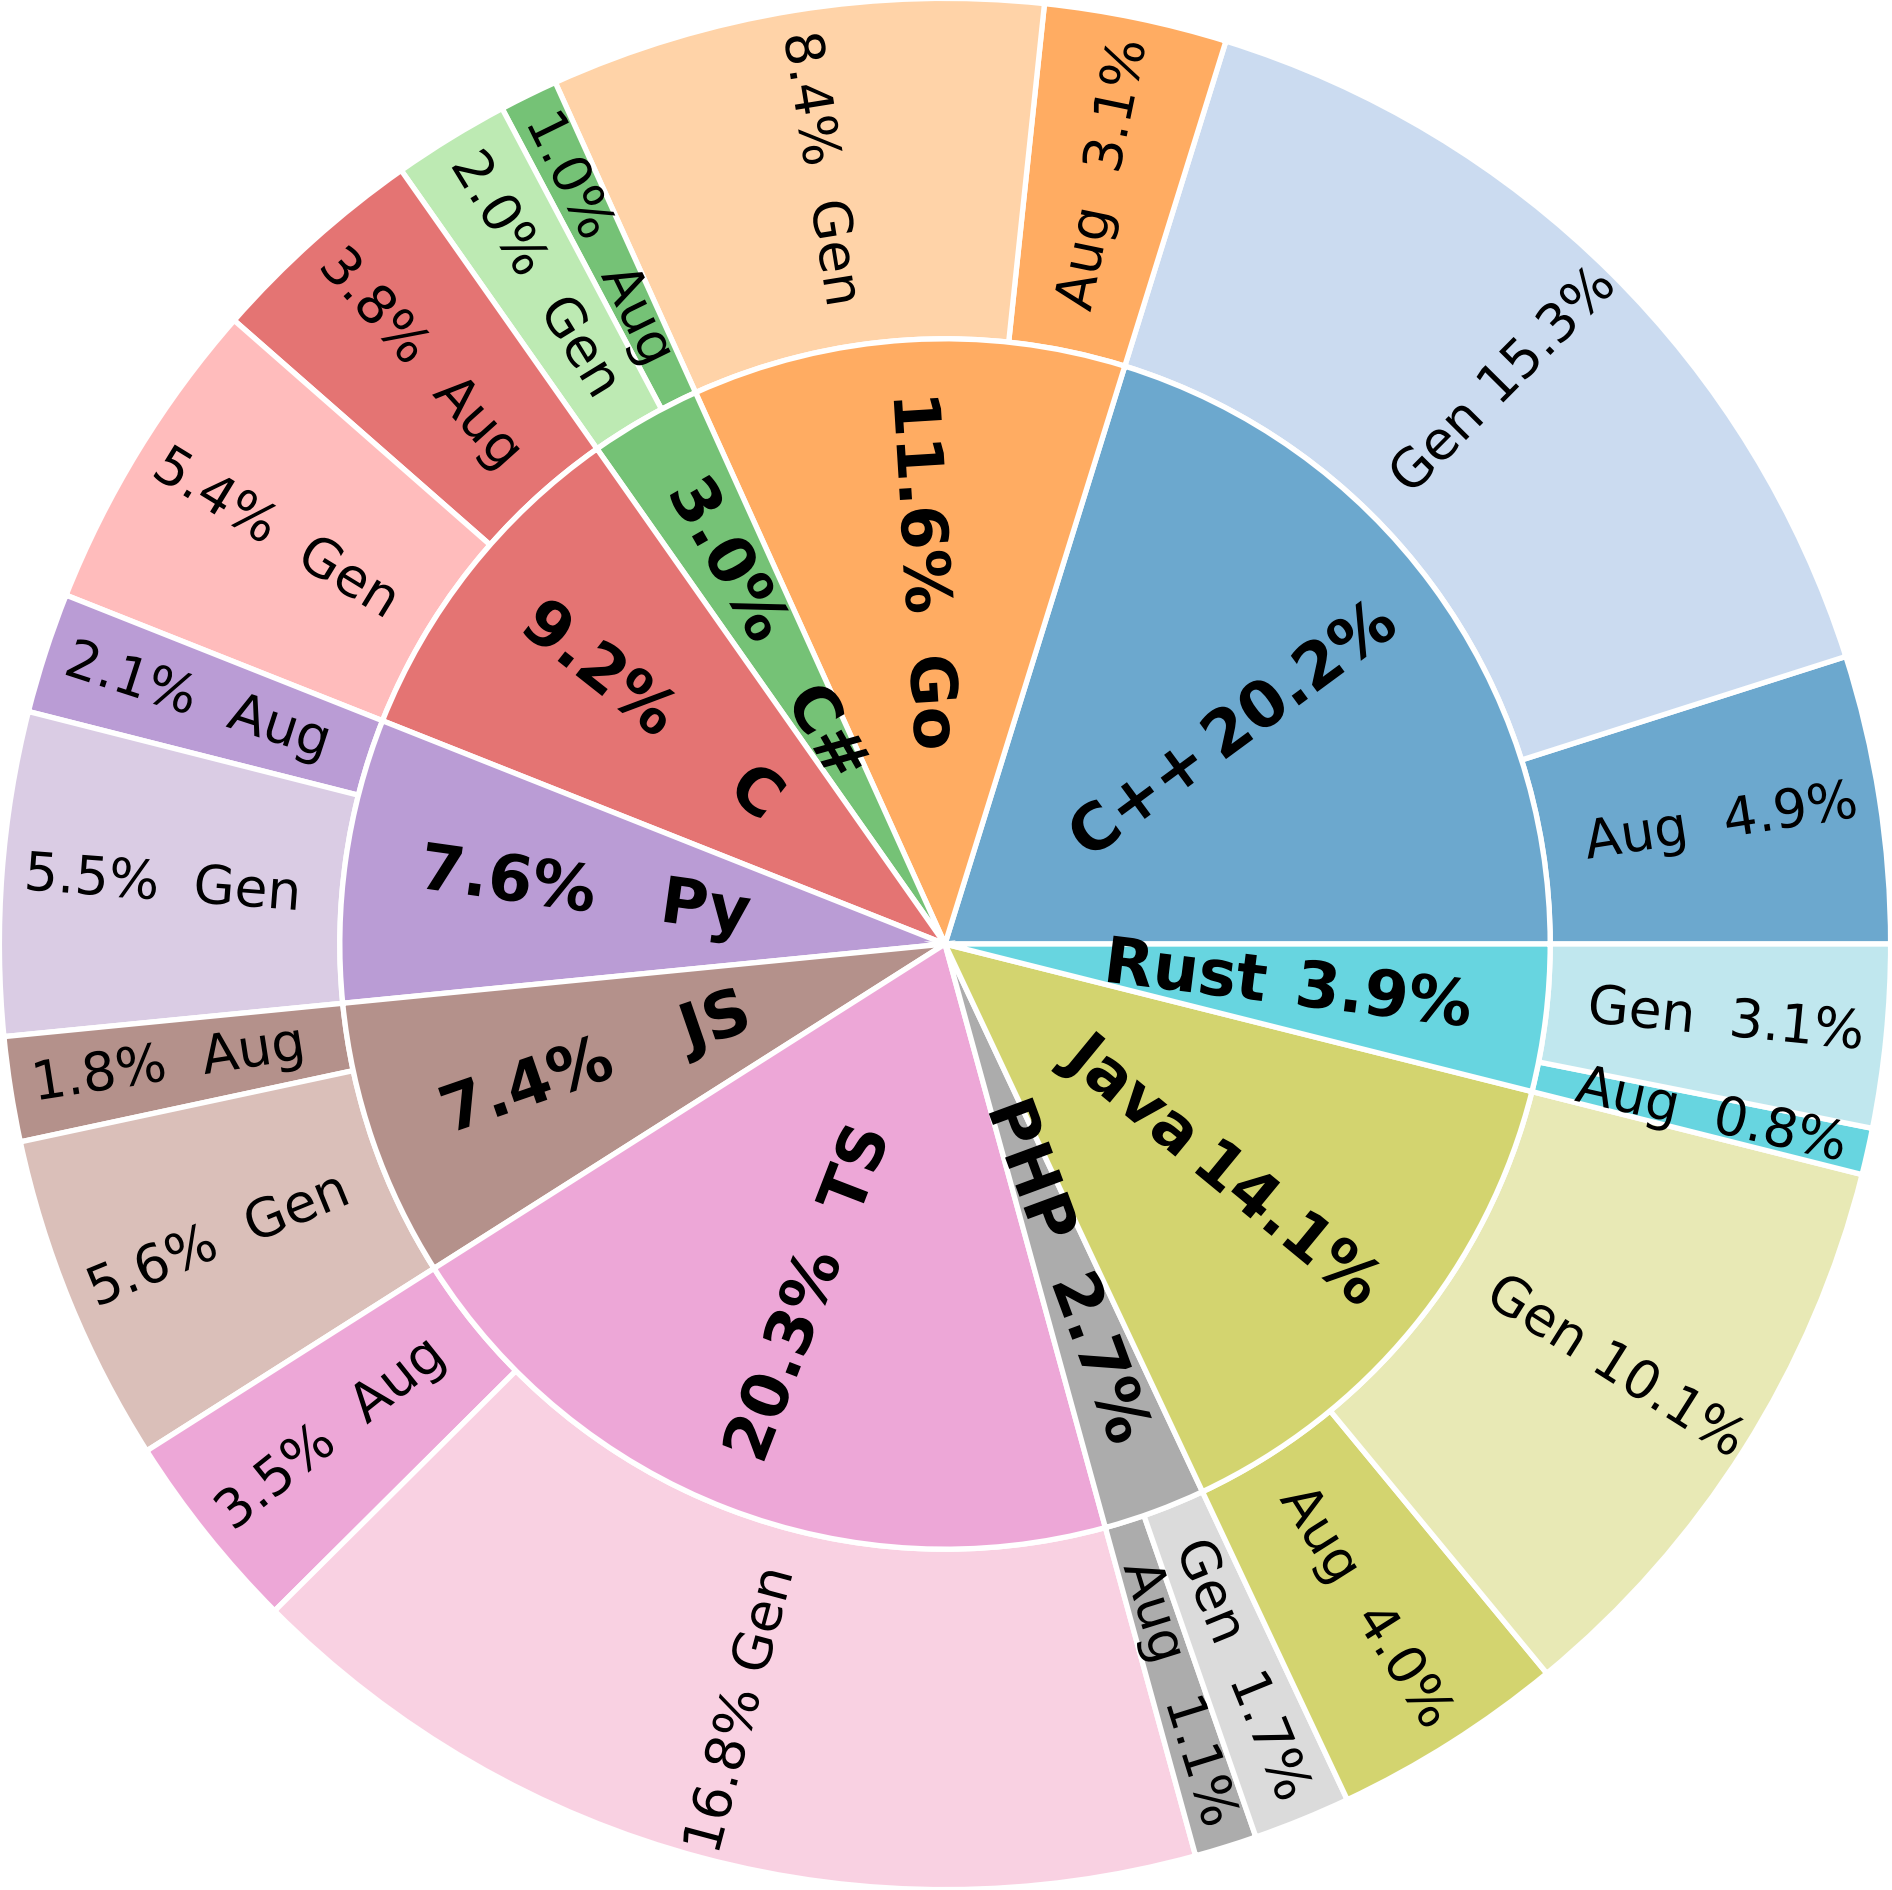
图 2: AACR-Bench 中评审评论的分布。TS、JS 与 Py 分别代表 TypeScript、JavaScript 与 Python。“Aug” 表示由原始 PR 评审增强得到的评论,“Gen” 表示由 6 个 LLM 生成的评论。
如第 1 节所述,现有基准存在单一语言局限,以及仅从历史 PR 数据得到的不完整 Ground Truth。为弥合这些差距,我们构建了 AACR-Bench——一个多语言、仓库级基准。核心考虑与处理如下。
编程语言与仓库的选择
为确保评测基准的时效性与多样性,我们依据 StackOverflow Developer Survey 20252 选取了排名前 10 的编程语言,即:JavaScript、Python、TypeScript、Java、C#、C++、C、PHP、Go 与 Rust。对每种语言,我们在 GitHub 上识别在 2024 年 12 月 1 日至 2025 年 12 月 1 日期间新增 star 数与已关闭 PR 数均进入前 2,000 的候选仓库。从该候选池中,我们选取新增 star 数最高的前 5 个仓库。因此,最终数据集包含这 10 种不同语言上的 50 个仓库(每种语言 5 个仓库),作为提取 PR 与评审评论的原始来源。
PR 过滤与评论增强
在从 50 个选定仓库提取的 PR 中,我们丢弃未识别出明确问题的评论。为保证数据质量,我们应用了五条过滤标准:(1) PR 标题与描述必须为英文;(2) 变更代码行数必须 $leq 1{,}000$(与 Google 关于有效评审的代码评审实践对齐 (Solmaz 2025));(3) 被修改文件的主要编程语言必须与仓库主语言匹配;(4) 一个 PR 必须包含 $>2$ 条行内评论,其中包括至少一条导致代码修改的被采纳评论;(5) 脱离项目业务上下文或缺乏语义含义的变更被排除。最后,为确保基准的代表性与多样性,我们基于仓库、PR 问题域 (Jimenez et al. 2023; Guo et al. 2025a) 以及变更规模,对过滤后的候选进行分层抽样,构建了包含 200 个 PR 的核心数据集。由于代码评审常涉及多轮对话,直接使用原始评论可能丢失上下文或引入噪声。我们聚焦每个 PR 中行内评论最多的修订版本,使用 LLM 对评审线程进行深度语义分析。这使得我们能够从多轮交互中提取已确认的代码缺陷,并将其重组为「增强评审评论」(Augmented Review Comments)。
评审补全与专家标注
为应对 GitHub PR 常被评审不足所导致的标签不完整(Label Incompleteness)(Bacchelli & Bird 2013),我们利用 LLM 全面补充每个 PR 的评审评论。我们构建了一个由 6 个主流开源与闭源模型组成的生成矩阵(Claude-4.5-Sonnet、Qwen3-Coder-480B-A35B-Instruct (Team 2025)、GPT-5.2、Deepseek-V3.2 (DeepSeek-AI 2025)、GLM-4.7 (Team et al. 2025)、Gemini-3-Pro),以减轻单模型偏差并确保输出多样性。评审评论通过两个异构框架并行生成:内部评审系统与开源 Agent Claude Code。经过语义去重后,生成的评论与增强后的人工评审合并,形成后续人工核验的候选集。该集合由 80 名高级软件工程师进行严格人工标注,每人具备两年以上专业经验。每条评论至少由两名标注者独立标注,任何分歧由六人核心团队讨论解决。标注者核验评论正确性并对问题类型进行分类 (Sun et al. 2025)。与现有基准不同,我们创新性地标注了形成每条评论所需的上下文层级,从而能够评估不同上下文依赖下的检测难度。该步骤共得到 1,505 条评审评论,其中 391 条由原始评审增强而来,1,114 条由 LLM 与人类专家增强而来,问题覆盖率提升了 285%。图 2 展示了语言分布以及增强的人工评论与模型生成评论的比例。
3.3 与现有数据集的比较
表 2: 现有基准与本文基准的比较
| 数据集 | 多语言支持 | 仓库级上下文支持 | 评审评论来源 | 上下文范围标注 |
|---|---|---|---|---|
| CodeFuse-CR-Bench | 否 | 是 | 原始数据 | 否 |
| SWR-Bench | 否 | 是 | 原始数据 | 否 |
| ContextCRBench | 是 | 否 | 原始数据 | 否 |
| AACR-Bench(本文) | 是 | 是 | LLM 与专家增强 | 是 |
现有 ACR 基准与本文基准的简要比较见表 2。我们的基准作为首个在多语言环境中提供仓库级上下文的基准而与众不同,综合了现有工作的优势。尽管 CodeFuse-CR-Bench (Guo et al. 2025a) 与 SWR-Bench (Zeng et al. 2025) 提供仓库上下文,但它们仅限于 Python;相反,ContextCRBench (Hu et al. 2025) 与 CodeReview (Li et al. 2022) 等多语言数据集则局限于文件级、函数级甚至 diff 级上下文。我们通过在 10 种流行编程语言上评测工具、并提供包括 PR 元数据与完整代码仓库在内的全面上下文来弥合这一差距。
此外,我们应对先前基准所使用的原始 GitHub 数据中固有的噪声与不完整性 (Guo et al. 2025a; Zeng et al. 2025; Hu et al. 2025; Li et al. 2022)。我们不依赖原始抽取,而是采用严格的构建方法:使用 LLM 从人工输入中增强技术问题,并用六个先进模型(包括 Qwen3-Coder-480B、GPT-5.2 与 Gemini-3-Pro)扩展缺陷覆盖。为确保可靠性,所有评论——无论是增强还是生成——均由一个由 80 名专业软件工程师组成的大规模团队仔细核验。
最后,除标准 PR 与评论标签外 (Guo et al. 2025a; Zeng et al. 2025; Hu et al. 2025),我们创新性地标注每条评审评论所需的上下文范围。这一新维度使得能够细粒度分析 ACR 方法在不同上下文深度与范围依赖下检测问题的能力。
4 实验
我们的实验旨在验证所提出数据集(AACR-Bench)核心新特征所带来的影响,即多语言支持、仓库级上下文,以及更全面的缺陷暴露水平。
4.1 评测设置
模型。 我们选取了主流开源提供商的最新模型以及主要商业大模型的最新版本。因此,实验包含三个开源模型(Qwen3-Coder-480B-A35B-Instruct (Team 2025)、DeepSeek-V3.2 (DeepSeek-AI 2025)、GLM-4.7 (Team et al. 2025))以及两个商业模型(GPT-5.2、Claude-4.5-Sonnet)。我们使用完整数据集评测了所有选定模型。为简便起见,后文将 Qwen3-Coder-480B-A35B-Instruct 称为 Qwen-480B-Coder。
上下文检索方法。 我们数据集的一个显著特征是提供仓库级上下文依赖。然而,不同检索方法也会显著影响模型的推理性能 (Zhang et al.; Liu et al. 2023b)。本实验采用以下方法:
- 无上下文(No context): 作为对照基线。
- BM25: 经典文本相似度方法 (Robertson et al. 2009),也曾用于先前类似研究 (Guo et al. 2025a)。
- Embedding: 采用当前最先进(SOTA)模型之一 Qwen3-Embedding-8B 进行向量相似度检索。
- 基于 Agent 的方法: 我们选择了广泛使用、支持代码评审的 Agent 框架 Claude Code。
此外需要指出,对于基于相似度的检索方法,检索到的代码上下文数量统一设为 3。相比之下,Agent 方法允许 Claude Code 框架自主决定检索的上下文数量。并且在所有情况下(即使是无上下文方法),都提供完全相同的 PR 标题与描述。
指标
我们使用常见的三项指标评测各类 ACR 方法在 AACR-Bench 上的表现,即 Precision、Recall 与 F1-score。
表 3: 不同 ACR 方法下各模型的性能比较(%)
| 方法 | 模型 | 平均评论数 | Recall (%) | Precision (%) | F1 (%) |
|---|---|---|---|---|---|
| Agent | Claude-4.5-Sonnet | 0.0890 | 10.10 | 39.90 | 16.12 |
| Deepseek-V3.2 | 0.1525 | 4.78 | 11.00 | 6.67 | |
| GLM-4.7 | 0.1448 | 4.72 | 11.50 | 6.69 | |
| GPT-5.2 | 0.1063 | 2.99 | 9.90 | 4.59 | |
| Qwen-480B-Coder | 0.1004 | 4.39 | 15.30 | 6.82 | |
| Embedding | Claude-4.5-Sonnet | 1.8902 | 42.86 | 8.00 | 13.48 |
| Deepseek-V3.2 | 2.5230 | 36.35 | 5.10 | 8.94 | |
| GLM-4.7 | 0.8657 | 26.98 | 11.00 | 15.63 | |
| GPT-5.2 | 2.4709 | 47.24 | 6.70 | 11.74 | |
| Qwen-480B-Coder | 0.8335 | 24.25 | 10.20 | 14.36 | |
| No context | Claude-4.5-Sonnet | 1.7220 | 42.86 | 8.70 | 14.46 |
| Deepseek-V3.2 | 2.2875 | 36.54 | 5.60 | 9.71 | |
| GLM-4.7 | 0.8573 | 27.57 | 11.30 | 16.03 | |
| GPT-5.2 | 2.3537 | 47.11 | 7.00 | 12.19 | |
| Qwen-480B-Coder | 1.0217 | 27.44 | 9.40 | 14.00 | |
| BM25 | Claude-4.5-Sonnet | 2.1698 | 35.75 | 5.80 | 9.98 |
| Deepseek-V3.2 | 0.8851 | 27.38 | 10.90 | 15.59 | |
| GLM-4.7 | 0.9070 | 26.25 | 10.20 | 14.69 | |
| GPT-5.2 | 1.7461 | 43.59 | 8.80 | 14.64 | |
| Qwen-480B-Coder | 2.3906 | 45.85 | 6.70 | 11.69 |
4.2 主要结果
本节给出多样化 ACR 方法与模型在我们基准上的全面评测。我们特别分析上下文检索、模型架构与 Agent 框架对所生成评审总体质量的影响。需要指出的是,当前 ACR 的实际应用 (Sadowski et al. 2015; Distefano et al. 2019) 以及先前研究 (Tao et al. 2012) 均一致强调上下文依赖信息在 ACR 中的关键作用。因此,本文所有实验均基于这一假设:这代表 ACR 所确立的真正范式。简言之,除非作为对照基线,我们不评测 LLM 在无上下文信息时的 ACR 任务表现。
4.2.1 在更充分的缺陷暴露下评测 ACR 性能
如表 3 的实验数据所示,基于 Agent 的方法呈现出与非 Agent 基线明显不同的评审表现。同时,引入上下文信息并不总能在 ACR 任务性能上带来正向增益。
基于 Agent 的方法与传统方法的比较
与传统方法相比,基于 Agent 的方法(例如 Claude Code)每个 patch 持续生成显著更少的评审评论($0.08sim 0.15$)。例如,Claude-4.5-Sonnet 在 Agent 模式下达到 $39.90%$ 的 Precision,远超其在「无上下文」模式下的 $8.70%$,但伴随明显更低的 Recall($10.10%$)。这表明,尽管 Agent 在对精度要求苛刻的场景中表现出色,它们可能忽略许多潜在缺陷——这一倾向可归因于其聚焦检索机制所诱发的「上下文隧道视野」(contextual tunnel vision)效应 (Liu et al. 2023a)。相比之下,传统方法往往产生过量评论(例如 GPT-5.2 平均每个 patch $2.47$ 条),可能在噪声中掩盖有意义的洞见。此外,基于 Agent 的方法的有效性表现出强烈的模型特异性依赖,这一敏感性在其他检索策略中并未观察到。尽管 Claude-4.5-Sonnet 在 Agent 模式下取得出色精度,其他模型并未展现类似增益,甚至可能出现性能下降。例如,GPT-5.2 尽管在「无上下文」模式下基线表现强劲,但在 Agent 模式下急剧下降,Precision 降至 $9.90%$,Recall 降至 $2.99%$。这一对比表明,通用模型能力并不能直接转化为基于 Agent 的 ACR 任务上的熟练度 (Liu et al. 2023c)。
上下文检索方法的影响
表 3 进一步表明,上下文检索并非普遍有益。对于固有推理能力强的模型,朴素 RAG 可能引入有害噪声,而各类开源模型对特定检索策略表现出不同偏好。例如,Claude-4.5-Sonnet 在「无上下文」模式下表现稳健(F1=$14.46$)。然而,通过 BM25 提供 top-3 上下文会导致性能急剧下降(F1=$9.98$,下降 $31%$;Precision 从 $8.70%$ 降至 $5.80%$)。基于 Embedding 的检索同样会使其结果变差。不同模型偏好不同策略。DeepSeek-V3.2 在 BM25 下取得最佳表现:每个 patch 的平均评论数从「无上下文」的 2.29 降至 $0.89$,同时 Precision 从 $5.10%$ 跃升至 $10.90%$,F1 达到 $15.59$。相反,Qwen-480B-Coder 在基于 Embedding 的检索下达到峰值(F1=$14.36$),显著优于其 BM25 分数($11.69$)。因此,没有一种检索方法对所有模型都最优;性能高度依赖于模型与检索模式的特定组合。
关键观察
基于 Agent 的方法持续产生远少于其他方法的评审评论,且其有效性强烈依赖于模型。该范式下不同 LLM 的表现差异显著。此外,不同模型对上下文检索方法的响应不同,例如将 Claude-4.5-Sonnet 与 Agent 框架配对、DeepSeek 与 BM25 配对、Qwen 与 Embedding 配对,持续呈现最优表现。
表 4: 不同 ACR 方法在不同上下文范围下发现问题的表现(仅 Recall)
| 方法 | 模型 | Diff | File | Repo |
|---|---|---|---|---|
| Agent | Claude-4.5-Sonnet | 11.95 | 16.84 | 13.77 |
| Deepseek-V3.2 | 4.28 | 4.64 | 8.00 | |
| GLM-4.7 | 6.50 | 5.95 | 4.40 | |
| GPT-5.2 | 3.21 | 2.52 | 3.45 | |
| Qwen-480B-Coder | 4.49 | 5.24 | 5.94 | |
| No context | Claude-4.5-Sonnet | 45.76 | 40.54 | 38.63 |
| Deepseek-V3.2 | 39.26 | 32.43 | 36.91 | |
| GLM-4.7 | 31.43 | 24.90 | 21.03 | |
| GPT-5.2 | 50.66 | 43.82 | 42.92 | |
| Qwen-480B-Coder | 33.82 | 22.59 | 17.60 | |
| BM25 | Claude-4.5-Sonnet | 46.68 | 41.31 | 38.63 |
| Deepseek-V3.2 | 38.20 | 32.82 | 34.33 | |
| GLM-4.7 | 29.71 | 27.61 | 19.31 | |
| GPT-5.2 | 48.94 | 43.82 | 40.34 | |
| Qwen-480B-Coder | 29.97 | 23.94 | 19.31 | |
| Embedding | Claude-4.5-Sonnet | 46.82 | 38.03 | 40.77 |
| Deepseek-V3.2 | 39.39 | 33.40 | 33.05 | |
| GLM-4.7 | 30.11 | 26.64 | 17.60 | |
| GPT-5.2 | 52.39 | 42.28 | 41.63 | |
| Qwen-480B-Coder | 27.06 | 22.78 | 18.45 |
4.2.2 上下文层级对 ACR 性能的影响
我们评估各类方法在识别需要不同上下文层级(定义见表 1)的问题上的效力。由于无法确知每次推理中隐式使用的精确上下文层级,我们仅报告 Recall 指标。
来自上下文层级的影响
如表 4 所示,除 Agent 框架这一显著例外,所有上下文检索方法(无上下文、BM25、Embedding)在不同上下文层级上都呈现出明显的性能衰减趋势,一致遵循 $text{Diff} > text{File} > text{Repo}$ 的层级。以「无上下文」方法为例:Qwen-480B-Coder 的表现从 Diff 级的 $33.82%$ 下降到 File 级的 $22.59%$,并进一步下降到 Repo 级的 $17.60%$。类似地,GPT-5.2 也呈现平行的下行轨迹。即便引入检索增强(BM25 或 Embedding),也无法逆转这种与上下文范围扩大相关的性能衰减现象。形成鲜明对比的是,Agent 框架(通过 Claude Code 实现)总体上呈现相反趋势,在复杂 Repo 级场景中常常优于孤立的 diff 场景。例如,在 Agent 框架下,DeepSeek-V3.2 的表现从 diff 级的 $4.28%$ 提升到 Repo 级的 $8.00%$;类似地,Qwen-480B-Coder 从 $4.49%$ 升至 $5.94%$。尽管这表明 Agent 可以利用多轮交互有效检索复杂上下文信息,但 diff 级上极低的分数(例如 DeepSeek 的 $4.28%$ 对比「无上下文」的 $39.26%$)可能意味着 Agent 会过分关注外部依赖,从而忽略 diff 本身固有的显眼局部问题。
关键观察
除基于 Agent 的方法外,ACR 方法检测问题的能力随所需上下文层级/范围增加而下降,而 Agent 方法呈现相反趋势。
4.2.3 语言维度对 ACR 性能的影响
图 3 显示,编程语言也可能影响各类 ACR 方法的表现,这在相当程度上证实了将基准扩展到多种编程语言的重要性。
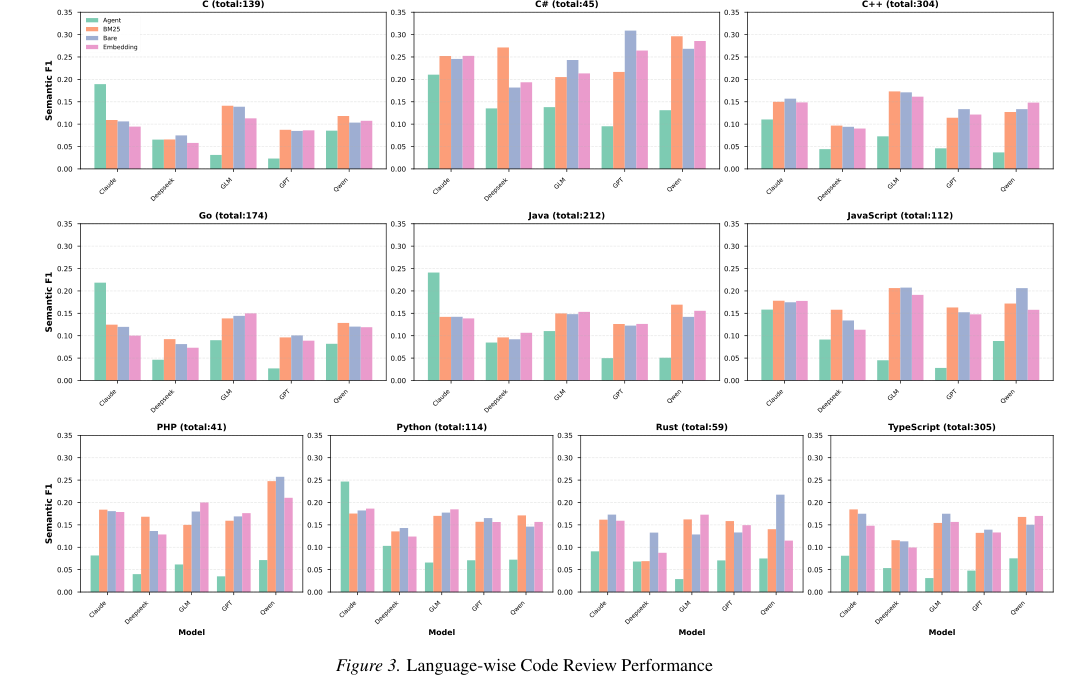
图 3: 分语言的代码评审表现
模型表现中的语言特异性偏差
不同 ACR 方法在各编程语言上的有效性差异相当大,揭示出强烈的语言特异性偏差。例如,Claude-4.5-Sonnet——Agent 任务中表现最好的模型——呈现出清晰的性能层级:它在 Python(0.247)、Java(0.241)、Go(0.218)与 C(0.189)上取得明显更高的 F1 分数,构成一个鲜明的第一梯队。相比之下,其在 TypeScript(0.081)、PHP(0.082)与 Rust(0.091)上的表现急剧下降,Python 与 TypeScript 之间的差距可达 3 倍。我们将这一差异主要归因于模型训练数据的不均衡分布。Python 与 Java 等语言拥有广泛的生态系统与大量高质量开源仓库,很可能提供了充足且经过良好整理的训练语料。相比之下,对 Rust 这类语言,相对稀缺的语料往往阻碍 LLM/Agent 获得执行准确规划步骤所需的知识。
同时,对所有主流框架(无上下文、BM25、Embedding、Agent)的交叉比较也显示,C# 表现出异常的可解释性与模型友好性,而 C 语言则持续处于性能谱系的底部。在无上下文的「No context」模式下,GPT-5.2 在 C# 上取得全面最高的 F1 分数(0.309),而同一模型在 C 上仅得 0.085。这一趋势进一步被 Qwen-480B-Coder 证实(C# $0.268$ vs. C $0.104$)。鉴于两种语言的应用现状,我们可合理假设 C# 与 C 为训练语料提供了可比的丰富程度。在此意义上,这一现象深刻反映了编程语言内在特征对 LLM 性能的影响。例如,作为强类型、面向对象的语言,C# 拥有严格的命名空间管理与显式类型定义。相比之下,C 严重依赖指针操作、宏定义与隐式内存管理。其依赖信息往往隐含在非结构化头文件或链接逻辑中。我们假设这类结构特征对 LLM 的 ACR 性能具有实质性影响。
上下文跨语言的性能影响
尽管通常预期上下文会改善模型表现,我们的实验揭示了一个反直觉趋势:引入上下文在大多数语言上导致显著的「上下文退步」(Contextual Backwardness),仅少数语言表现出稳健性。比较「无上下文」模式与「Agent/检索」模式,揭示出两种不同的行为模式。对 C#、C++、JavaScript、PHP、Python、Rust 与 TypeScript,引入复杂上下文框架反而引入了噪声。以 GPT-5.2 为例,其在 C# 上的表现从「无上下文」模式的 0.309 骤降至 Agent 模式的 0.095;类似地,Python 从 0.165 降至 0.071。这表明对这些语言,外部检索的上下文或 Agent 生成的冗余规划步骤严重干扰了模型的内在判断。相比之下,仅 C、Go 与 Java 在复杂上下文中保持稳定甚至取得提升。最突出的例子是 Claude-4.5-Sonnet,它通过 Agent 框架在 Go($0.120rightarrow 0.218$)、Java($0.142rightarrow 0.241$)与 C($0.106rightarrow 0.189$)上实现了实质性性能跃升。这表明,当考虑是否向模型提供上下文信息以改善其 ACR 表现时,答案完全取决于编程语言。
关键观察
不同 ACR 方法表现出显著的语言特异性偏差。对某些语言,引入上下文检索方法甚至可能降低性能。
5 错误分析
模型生成的错误评审评论的详细案例研究见附录 D。我们观察到,当前模型在代码评审中仍持续遭受知识错误。此外,上下文检索引入的噪声数据被识别为导致生成错误评审评论的重要因素。
6 结论
我们提出了 AACR-Bench,一个旨在以仓库级上下文评测 ACR 系统的多语言基准。AACR-Bench 通过更好地衡量各类方法利用复杂仓库级上下文执行 ACR 的能力,填补了该领域的一项关键空白。我们在 AACR-Bench 上的广泛实证评测表明:
上下文的粒度/层级以及检索方法的选择会显著影响 ACR 性能,且这种影响随 LLM、编程语言以及 LLM 使用范式(例如是否采用 Agent 架构)而变化。
尽管上述发现有力强调了构建 AACR-Bench 这类数据集的必要性,我们的工作也存在局限。具体而言,尽管我们利用 LLM 生成的评审来增强数据集,但由于真实软件系统固有的复杂性与主观性,构建完全全面的 Ground Truth 仍是一项艰巨挑战。未来工作将聚焦于进一步扩大数据集规模,并探索更先进的半自动方法以精炼 Ground Truth 质量。
影响声明
本工作引入 AACR-Bench,这是面向自动化代码评审的首个多语言、仓库级上下文感知基准。通过全面刻画当前大语言模型的能力边界,我们的研究识别出关键挑战,并为下一代 ACR 系统指明方向。
自动化代码评审中的范式转变
我们的研究建立了严格的评测标准,并揭示了未来 ACR 方法为实现实用效用应应对的三项根本挑战:
- 驾驭 Precision–Recall 权衡: 我们识别出一种鲜明的二分:传统生成方法最大化 Recall 但遭受频繁幻觉,而基于 Agent 的方法在缺陷定位上达到高 Precision 但缺乏全面覆盖。这一发现敦促社区超越单一指标优化,聚焦于在保持高精度的同时扩大缺陷检测覆盖的混合架构。
- 迈向自适应上下文感知: 我们挑战「更多上下文总是更好」的流行假设。实证结果表明,检索上下文的影响在不同语言间差异显著(例如 C# vs. Python),不相关上下文往往充当噪声。这需要转向自适应上下文感知(Adaptive Context Awareness),要求系统具备元认知能力,以根据代码特征与任务类型动态确定检索的必要性与粒度。
- 统一局部与全局视角: 我们观察到,尽管检索增强生成(RAG)有助于全局依赖理解,其所诱发的噪声会损害 Diff 内局部缺陷的检测。相反,易出现「上下文隧道」的 Agent 常常忽略明显的局部错误。未来迭代必须发展动态注意力机制,将微观语法核验与宏观跨文件风险评估有机整合。
从被动摄入到主动审计
本工作重新框定了 ACR 中「上下文有效性」的评测。我们认为,高质量代码评审较少依赖于信息检索,而更多依赖于信息利用与推理稳健性。我们的发现表明,若没有足够的噪声容忍能力,即使通过 BM25 或 Embedding 检索到相关代码也可能降低性能。Agent 在复杂场景中更优的推理表明,从「被动代码摄入」(接收预先检索的片段)转向「主动代码审计」的范式转变。使模型能够主动探索上下文、通过多轮交互验证假设并过滤噪声——模仿人类专家行为——代表了实现可靠自动化代码评审最有前景的方向。
参考文献
- Bacchelli & Bird (2013) Bacchelli, A. and Bird, C. Expectations, outcomes, and challenges of modern code review. In 2013 35th International Conference on Software Engineering (ICSE), pp. 712–721. IEEE, 2013.
- DeepSeek-AI (2025) DeepSeek-AI. Deepseek-v3.2: Pushing the frontier of open large language models, 2025.
- Distefano et al. (2019) Distefano, D., Fähndrich, M., Logozzo, F., and O’Hearn, P. W. Scaling static analyses at facebook. Communications of the ACM, 62(8):62–70, 2019.
- Guo et al. (2025a) Guo, H., Zheng, X., Liao, Z., Yu, H., Di, P., Zhang, Z., and Dai, H.-N. Codefuse-cr-bench: A comprehensiveness-aware benchmark for end-to-end code review evaluation in python projects. arXiv preprint arXiv:2509.14856, 2025a.
- Guo et al. (2025b) Guo, J., Wang, C., Xu, X., Su, Z., and Zhang, X. Repoaudit: An autonomous llm-agent for repository-level code auditing. arXiv preprint arXiv:2501.18160, 2025b.
- Hou et al. (2024) Hou, X., Zhao, Y., Liu, Y., Yang, Z., Wang, K., Li, L., Luo, X., Lo, D., Grundy, J., and Wang, H. Large language models for software engineering: A systematic literature review. ACM Transactions on Software Engineering and Methodology, 33(8):1–79, 2024.
- Hu et al. (2025) Hu, R., Wang, X., Wen, X.-C., Zhang, Z., Jiang, B., Gao, P., Peng, C., and Gao, C. Benchmarking llms for fine-grained code review with enriched context in practice. arXiv preprint arXiv:2511.07017, 2025.
- Jimenez et al. (2023) Jimenez, C. E., Yang, J., Wettig, A., Yao, S., Pei, K., Press, O., and Narasimhan, K. Swe-bench: Can language models resolve real-world github issues? arXiv preprint arXiv:2310.06770, 2023.
- Kapadnis et al. (2025) Kapadnis, M. N., Naik, A., and Rose, C. Crscore++: Reinforcement learning with verifiable tool and ai feedback for code review. arXiv preprint arXiv:2506.00296, 2025.
- Khoshnoud et al. (2022) Khoshnoud, F., Nasab, A. R., Toudeji, Z., and Sami, A. Which bugs are missed in code reviews: An empirical study on smartshark dataset. In Proceedings of the 19th International Conference on Mining Software Repositories, pp. 137–141, 2022.
- Le et al. (2022) Le, H., Wang, Y., Gotmare, A. D., Savarese, S., and Hoi, S. C. H. Coderl: Mastering code generation through pretrained models and deep reinforcement learning. Advances in Neural Information Processing Systems, 35:21314–21328, 2022.
- Li et al. (2025) Li, S., Wang, D., Thongtanunam, P., Wang, Z., Yu, J., and Chen, J. Issue-oriented agent-based framework for automated review comment generation. arXiv preprint arXiv:2511.00517, 2025.
- Li et al. (2022) Li, Z., Lu, S., Guo, D., Duan, N., Jannu, S., Jenks, G., Majumder, D., Green, J., Svyatkovskiy, A., Fu, S., et al. Automating code review activities by large-scale pre-training. In Proceedings of the 30th ACM Joint European Software Engineering Conference and Symposium on the Foundations of Software Engineering, pp. 1035–1047, 2022.
- Liu et al. (2025) Liu, C., Lin, H. Y., and Thongtanunam, P. Too noisy to learn: Enhancing data quality for code review comment generation. In 2025 IEEE/ACM 22nd International Conference on Mining Software Repositories (MSR), pp. 236–248. IEEE, 2025.
- Liu et al. (2023a) Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., and Liang, P. Lost in the middle: How language models use long contexts, 2023. URL https://arxiv.org/abs/2307.03172, 2023a.
- Liu et al. (2023b) Liu, T., Xu, C., and McAuley, J. Repobench: Benchmarking repository-level code auto-completion systems. arXiv preprint arXiv:2306.03091, 2023b.
- Liu et al. (2023c) Liu, X., Yu, H., Zhang, H., Xu, Y., Lei, X., Lai, H., Gu, Y., Ding, H., Men, K., Yang, K., et al. Agentbench: Evaluating llms as agents. arXiv preprint arXiv:2308.03688, 2023c.
- Lu et al. (2023) Lu, J., Yu, L., Li, X., Yang, L., and Zuo, C. Llama-reviewer: Advancing code review automation with large language models through parameter-efficient fine-tuning. In 2023 IEEE 34th International Symposium on Software Reliability Engineering (ISSRE), pp. 647–658. IEEE, 2023.
- Ren et al. (2025) Ren, X., Dai, C., Huang, Q., Wang, Y., Liu, C., and Jiang, B. Hydra-reviewer: A holistic multi-agent system for automatic code review comment generation. IEEE Transactions on Software Engineering, 2025.
- Robertson et al. (2009) Robertson, S., Zaragoza, H., et al. The probabilistic relevance framework: Bm25 and beyond. Foundations and trends® in information retrieval, 3(4):333–389, 2009.
- Sadowski et al. (2015) Sadowski, C., Van Gogh, J., Jaspan, C., Soderberg, E., and Winter, C. Tricorder: Building a program analysis ecosystem. In 2015 IEEE/ACM 37th IEEE International Conference on Software Engineering, volume 1, pp. 598–608. IEEE, 2015.
- Sharanarthi & Polineni (2025) Sharanarthi, T. and Polineni, S. Multi-agent llm collaboration for adaptive code review, debugging, and security analysis. In 2025 International Conference on Mechatronics, Robotics, and Artificial Intelligence (MRAI), pp. 541–546. IEEE, 2025.
- Solmaz (2025) Solmaz, O. Google’s Code Review Guidelines (GitHub Adaptation), September 2025. URL https://solmaz.io/google-eng-practices-github. Accessed: 2026-01-28.
- Sun et al. (2025) Sun, T., Xu, J., Li, Y., Yan, Z., Zhang, G., Xie, L., Geng, L., Wang, Z., Chen, Y., Lin, Q., et al. Bitsai-cr: Automated code review via llm in practice. In Proceedings of the 33rd ACM International Conference on the Foundations of Software Engineering, pp. 274–285, 2025.
- Tang et al. (2024) Tang, X., Kim, K., Song, Y., Lothritz, C., Li, B., Ezzini, S., Tian, H., Klein, J., and Bissyandé, T. F. Codeagent: Autonomous communicative agents for code review. arXiv preprint arXiv:2402.02172, 2024.
- Tao et al. (2012) Tao, Y., Dang, Y., Xie, T., Zhang, D., and Kim, S. How do software engineers understand code changes? an exploratory study in industry. In Proceedings of the ACM SIGSOFT 20th International symposium on the foundations of software engineering, pp. 1–11, 2012.
- Team et al. (2025) Team, G., Zeng, A., Lv, X., Zheng, Q., Hou, Z., Chen, B., Xie, C., Wang, C., Yin, D., Zeng, H., Zhang, J., Wang, K., Zhong, L., Liu, M., Lu, R., Cao, S., Zhang, X., Huang, X., Wei, Y., Cheng, Y., An, Y., Niu, Y., Wen, Y., Bai, Y., Du, Z., Wang, Z., Zhu, Z., Zhang, B., Wen, B., Wu, B., Xu, B., Huang, C., Zhao, C., Cai, C., Yu, C., Li, C., Ge, C., Huang, C., Zhang, C., Xu, C., Zhu, C., Li, C., Yin, C., Lin, D., Yang, D., Jiang, D., Ai, D., Zhu, E., Wang, F., Pan, G., Wang, G., Sun, H., Li, H., Li, H., Hu, H., Zhang, H., Peng, H., Tai, H., Zhang, H., Wang, H., Yang, H., Liu, H., Zhao, H., Liu, H., Yan, H., Liu, H., Chen, H., Li, J., Zhao, J., Ren, J., Jiao, J., Zhao, J., Yan, J., Wang, J., Gui, J., Zhao, J., Liu, J., Li, J., Li, J., Lu, J., Wang, J., Yuan, J., Li, J., Du, J., Du, J., Liu, J., Zhi, J., Gao, J., Wang, K., Yang, L., Xu, L., Fan, L., Wu, L., Ding, L., Wang, L., Zhang, M., Li, M., Xu, M., Zhao, M., Zhai, M., Du, P., Dong, Q., Lei, S., Tu, S., Yang, S., Lu, S., Li, S., Li, S., Shuang-Li, Yang, S., Yi, S., Yu, T., Tian, W., Wang, W., Yu, W., Tam, W. L., Liang, W., Liu, W., Wang, X., Jia, X., Gu, X., Ling, X., Wang, X., Fan, X., Pan, X., Zhang, X., Zhang, X., Fu, X., Zhang, X., Xu, Y., Wu, Y., Lu, Y., Wang, Y., Zhou, Y., Pan, Y., Zhang, Y., Wang, Y., Li, Y., Su, Y., Geng, Y., Zhu, Y., Yang, Y., Li, Y., Wu, Y., Li, Y., Liu, Y., Wang, Y., Li, Y., Zhang, Y., Liu, Z., Yang, Z., Zhou, Z., Qiao, Z., Feng, Z., Liu, Z., Zhang, Z., Wang, Z., Yao, Z., Wang, Z., Liu, Z., Chai, Z., Li, Z., Zhao, Z., Chen, W., Zhai, J., Xu, B., Huang, M., Wang, H., Li, J., Dong, Y., and Tang, J. Glm-4.5: Agentic, reasoning, and coding (arc) foundation models, 2025. URL https://arxiv.org/abs/2508.06471.
- Team (2025) Team, Q. Qwen3 technical report, 2025. URL https://arxiv.org/abs/2505.09388.
- Tufano et al. (2022) Tufano, R., Masiero, S., Mastropaolo, A., Pascarella, L., Poshyvanyk, D., and Bavota, G. Using pre-trained models to boost code review automation. In Proceedings of the 44th international conference on software engineering, pp. 2291–2302, 2022.
- Yu et al. (2024a) Yu, Y., Rong, G., Shen, H., Zhang, H., Shao, D., Wang, M., Wei, Z., Xu, Y., and Wang, J. Fine-tuning large language models to improve accuracy and comprehensibility of automated code review. ACM transactions on software engineering and methodology, 34(1):1–26, 2024a.
- Yu et al. (2024b) Yu, Y., Zhang, L., Rong, G., Shen, H., Zhang, J., Yan, H., Shi, G., Shao, D., Pan, R., Li, Y., et al. Distilling desired comments for enhanced code review with large language models. arXiv preprint arXiv:2412.20340, 2024b.
- Zeng et al. (2025) Zeng, Z., Shi, R., Han, K., Li, Y., Sun, K., Wang, Y., Yu, Z., Xie, R., Ye, W., and Zhang, S. Benchmarking and studying the llm-based code review. arXiv preprint arXiv:2509.01494, 2025.
- Zhang et al. Zhang, F., Chen, B., Zhang, Y., Keung, J., Liu, J., Zan, D., Mao, Y., Lou, J.-G., and Chen, W. Repocoder: Repository-level code completion through iterative retrieval and generation. In The 2023 Conference on Empirical Methods in Natural Language Processing.
- Zhang et al. (2023) Zhang, Q., Fang, C., Xie, Y., Zhang, Y., Yang, Y., Sun, W., Yu, S., and Chen, Z. A survey on large language models for software engineering. arXiv preprint arXiv:2312.15223, 2023.
- Zhang et al. (2025) Zhang, Y., Zhang, Y., Sun, Z., Jiang, Y., and Liu, H. Laura: Enhancing code review generation with context-enriched retrieval-augmented llm. arXiv preprint arXiv:2512.01356, 2025.
附录 A 附录概览
附录组织如下:
- 第 B 节提供 AACR-Bench 的详细信息,包括数据构建过程、与现有基准的比较,以及代表性数据样本。
- 第 C 节描述 AACR-Bench 的实验设置,涵盖完整评测流水线、所测模型、超参数设置,以及细粒度结果分析。
- 第 D 节提供基于 AACR-Bench 评测结果的案例研究。
附录 B 数据集细节
B.1 详细数据集构建过程
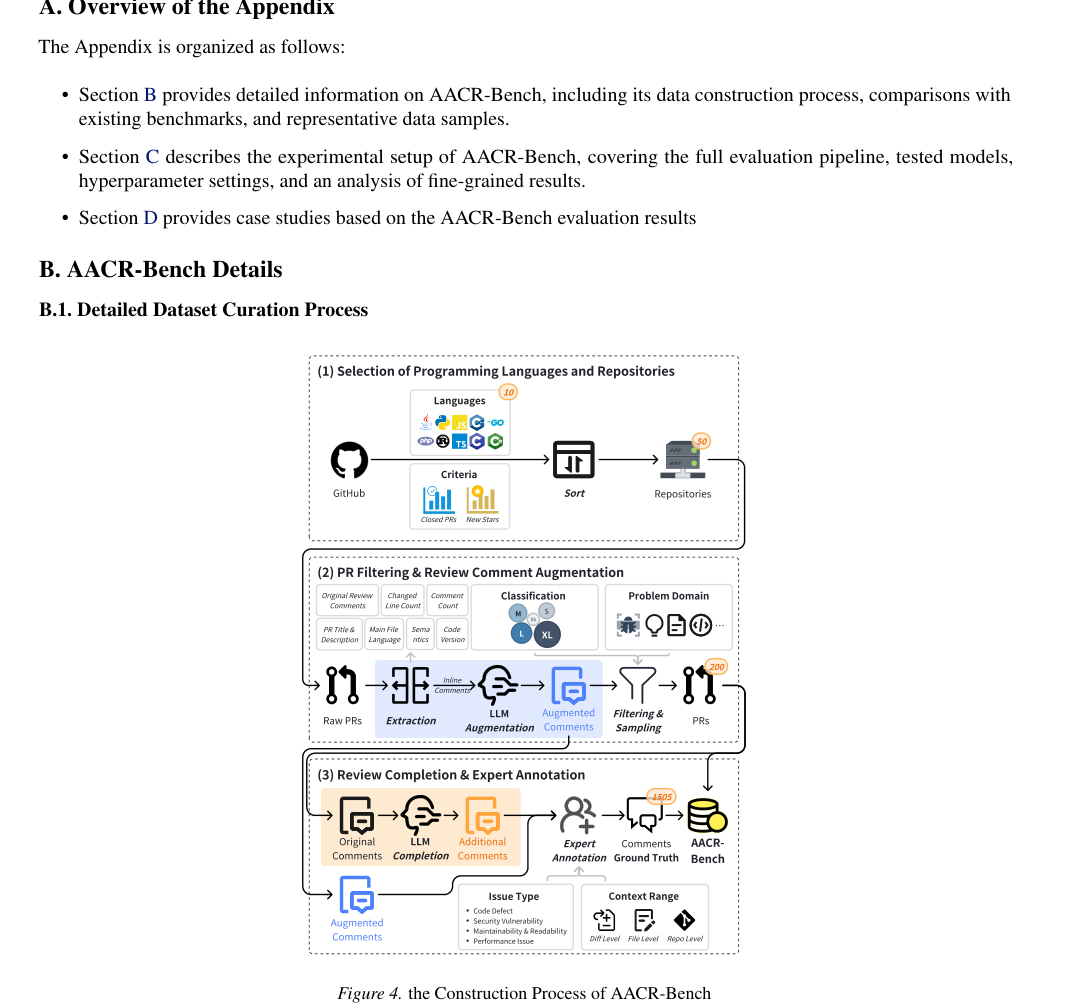
图 4: AACR-Bench 的构建过程
AACR-Bench 的构建过程如图 4 所示。
编程语言与仓库的选择
为确保评测数据的时效性与编程语言的多样性,我们依据 StackOverflow Developer Survey 2025 选取了排名前十的编程语言,具体为:JavaScript、Python、TypeScript、Java、C#、C++、C、PHP、Go 与 Rust。对每种语言,我们选取该语言作为主要编程语言的仓库,作为 PR 信息提取的数据源,并遵循以下标准:首先,我们定义一个活跃 GitHub 仓库候选集,这些仓库在 2024 年 12 月 1 日至 2025 年 12 月 1 日期间新增 star 数与已关闭 PR 数均进入前 2,000。随后,我们按新增 star 数对候选仓库排序,并为每种语言选取前五名。最终,我们构建了跨越 10 种编程语言的 50 个高活跃仓库集合(每种语言五个仓库),作为提取 PR 与评审评论的来源。
PR 过滤与评审评论增强
聚焦于选定的 50 个仓库,我们利用 GitHub API 收集 2024 年 12 月 1 日至 2025 年 12 月 1 日期间创建的全部 Pull Request(PR),共得到 $12{,}715$ 条记录。对每个 PR,我们提取以下关键信息:
- PR 的标题与描述;
- 变更的代码行数;
- PR 的 base commit;
- 全面的评审评论数据,包括目标修订版本、相关文件路径、行范围,以及评审的具体内容。
基于上述原始数据,我们实施了以下预处理步骤:
- 领域分类: 使用大语言模型(LLM)分析 PR 的问题域,遵循 SWE-Bench 中定义的分类体系,如表 5 所示;
- 语言识别: 分析 PR 标题与描述所使用的自然语言;
- 修订版本选择: 识别并提取包含评审评论数量最多的修订版本,以及全部对应评审数据;
- 规模分类: 基于变更行数对 PR 规模进行分类,遵循 T-Shirt Size 分类方法,如表 6 所示。
- 被评审编程语言识别: 基于评审评论所针对文件的扩展名,识别被评审代码的主要编程语言。
表 5: PR 问题域分类
| 类别(缩写) | 描述 | PR 数量 |
|---|---|---|
| Bug Fixes (BF) | 解决功能性错误、崩溃、不正确输出 | 53 |
| New Feature Additions (NFA) | 向应用添加新功能或特性 | 44 |
| Code Refactoring (CA) | 在不改变外部行为的前提下改善代码结构、可读性、可维护性 | 28 |
| Documentation Update (DU) | 与代码注释或外部文档相关的变更 | 12 |
| Test Suite / CI Enhancements (TC) | 改善测试覆盖、测试质量或持续集成流程 | 20 |
| Performance Optimizations (PO) | 改善应用速度、响应时间或资源使用效率 | 19 |
| Security Patches (SV) | 修复可能导致安全问题的代码缺陷 | 13 |
| Dependency Updates (DE) | 更新第三方库依赖或确保跨环境兼容性 | 3 |
| Code Style, Linting (CLF) | 确保代码符合团队编码标准与一致性 | 8 |
表 6: PR 规模的 T-Shirt Size 分类
| 规模 | 变更行数 | PR 数量 |
|---|---|---|
| XS | 0 - 9 | 8 |
| S | 10 - 29 | 22 |
| M | 30 - 99 | 47 |
| L | 100 - 499 | 89 |
| XL | 500 - 999 | 34 |
| XXL | 1000+ | 0 |
对领域分类任务,我们采用 Qwen3-235B-A22B-Thinking-2507 模型;所用具体 prompt 见图 5。为评估分类可靠性,我们从结果中随机抽样 350 个实例进行人工核验。分析显示准确率为 $92.36%$。在 $95%$ 置信水平下,该结果的误差范围为 $5.06%$。
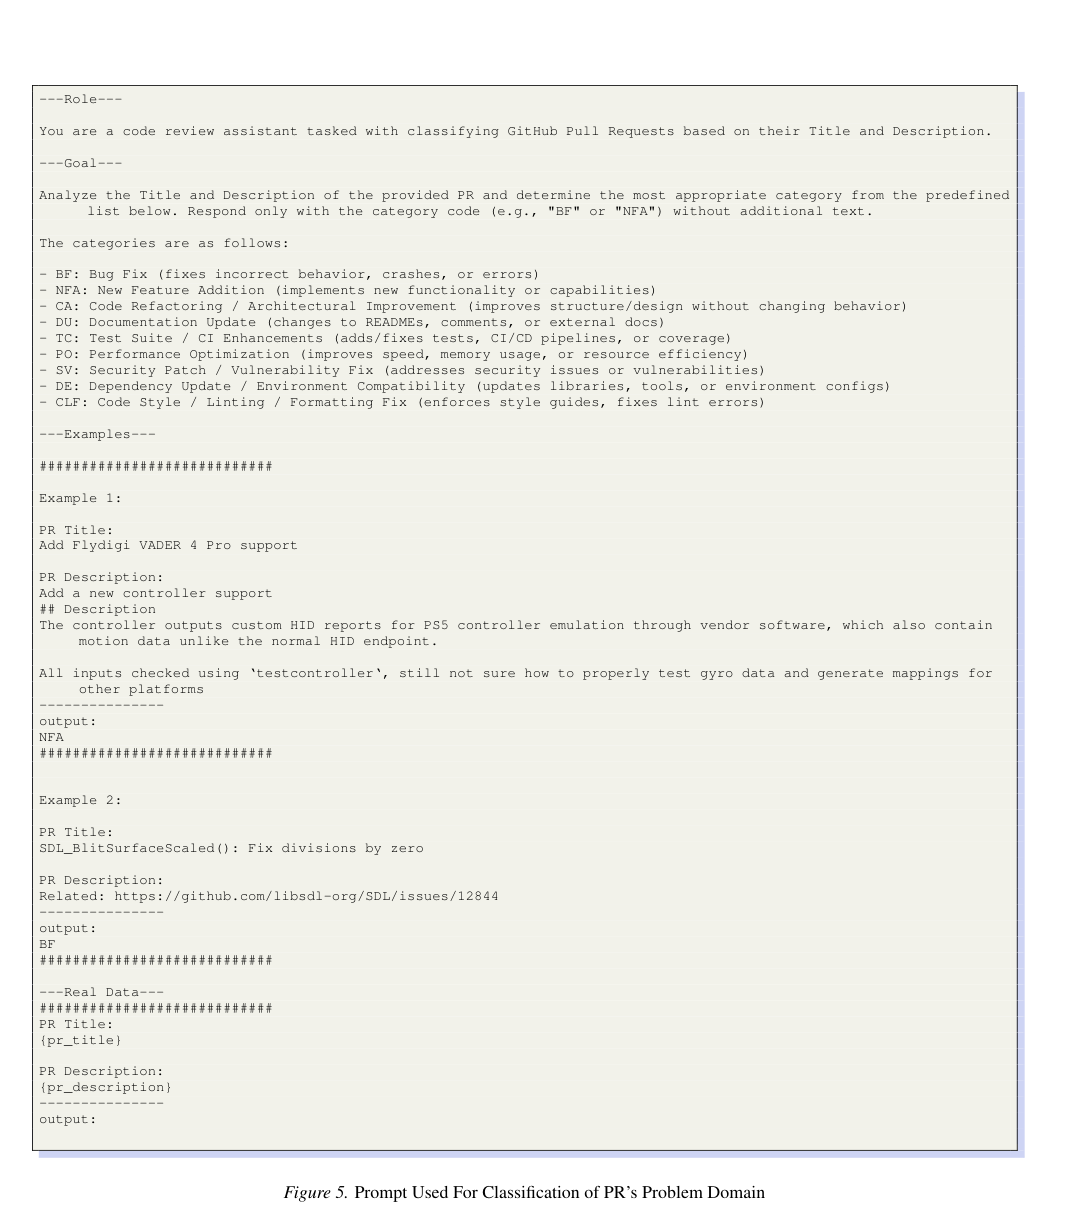
图 5: 用于 PR 问题域分类的 Prompt
在预处理数据的基础上,我们建立了五条过滤标准以自动筛选高质量样本,得到 3,328 个 PR 条目:
- 语言标准: PR 的标题与描述必须以英文撰写。
- 规模约束: 变更代码行数必须限制为 1,000。根据 Google 的代码评审实践,超过该阈值的变更被认为过大而无法有效评审。
- 语言一致性: 主要修改文件的编程语言必须与仓库主语言匹配。
- 评审丰富度: PR 必须包含至少两条行内评论,其中包括至少一条被接受(即导致代码修改)的建设性评论。
我们对初步过滤后的 PR 进行了第二轮人工核验。聚焦语义有效性,我们排除了脱离项目业务上下文或缺乏实际语义含义的琐碎变更。该过程得到最终的 573 个 PR 数据集。
最后,为确保基准的代表性与多样性,我们基于来源仓库、问题域与 PR 规模对候选池进行分层抽样。该过程得到由 200 个 PR 组成的最终数据集。这些 PR 在问题域与规模上的分布分别见图 6 与图 7。
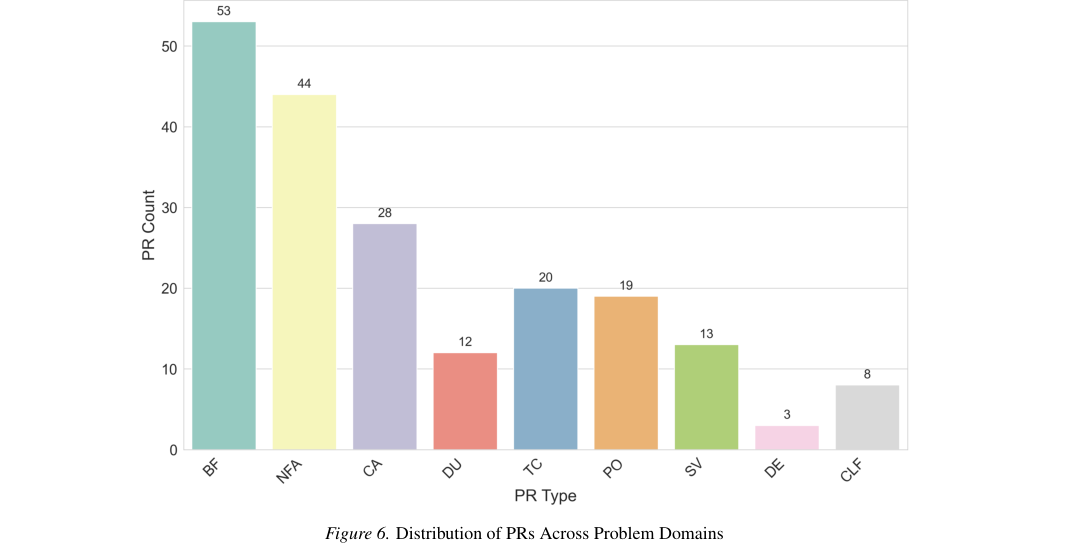
图 6: PR 在各问题域上的分布
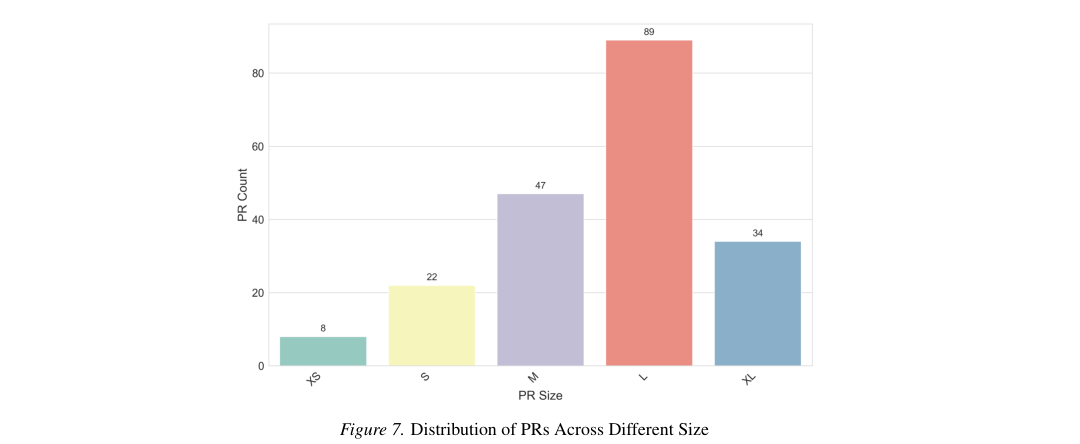
图 7: PR 在不同规模上的分布
鉴于代码评审常涉及评审者与开发者之间的多轮对话以核验问题有效性,原始评论可能遭受上下文缺失与噪声。为应对此问题,我们使用 LLM 对选定修订版本的评审线程进行深度语义分析。具体而言,我们从这些多轮交互中提取已确认的代码缺陷,并将其合成为「增强评审评论」,同时丢弃未指出实质性的评论。该过程所用 prompt 见图 8。我们将此增强过程应用于 $1{,}119$ 个对话线程,并抽样 $300$ 个结果进行正确性的人工评估。若模型准确提供识别线程中已确认代码问题的评审评论,或正确判定该线程不包含代码问题,则增强结果被定义为「正确」。评估结果表明准确率为 95%,置信水平为 95%,误差范围为 4.74%。
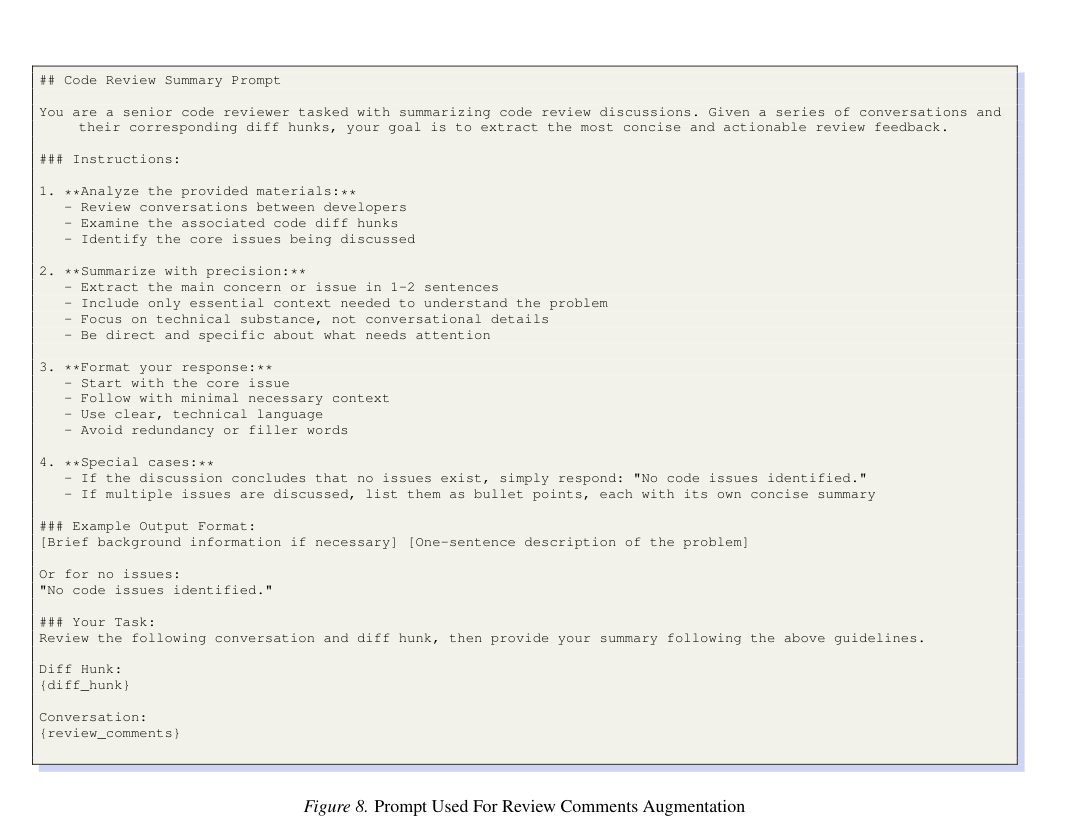
图 8: 用于评审评论增强的 Prompt
表 7: 评审评论中揭示的问题类别
| 问题类别 | 描述 | 评论数量 |
|---|---|---|
| Security Vulnerability | 代码中可能导致数据泄露、未授权访问或易受其他恶意攻击的安全弱点 | 53 |
| Code Defect | 可能导致运行时崩溃、产生不正确结果或导致意外系统行为的逻辑错误或实现缺陷 | 709 |
| Maintainability & Readability | 与编码风格或结构设计相关、降低代码可读性并阻碍未来理解与维护的问题 | 626 |
| Performance Issue | 算法低效或资源管理不当导致的非功能性瓶颈,例如高延迟、吞吐量不足或资源消耗过高 | 117 |
评审补全与专家标注
受限于人类评审者的认知边界与能力限制,仅依赖人工努力往往无法发现全部潜在代码缺陷。为应对由此产生的「问题标注不完整」问题,我们采用 LLM 生成技术全面增强评审评论。为减轻单模型偏差并确保多样性,我们构建了由六个主流开源与专有模型组成的生成矩阵。这些模型通过两个异构框架并行生成评审评论:内部评审系统与开源 Agent 系统(Claude Code)。所有生成评论在与先前增强的人工评审评论合并前都经过语义去重,形成核验候选集。该语义去重使用 Qwen3-235B-A22B-Thinking-2507 执行。具体而言,所有评审评论首先基于其仓库、Pull Request(PR)、文件路径以及所针对的特定 Diff Hunk 分组。在每组内,评论通过 LLM 进行两两比较,并根据比较结果去除重复项。该比较所用 prompt 见图 9。我们采用运行 5 次判断的结果选举。
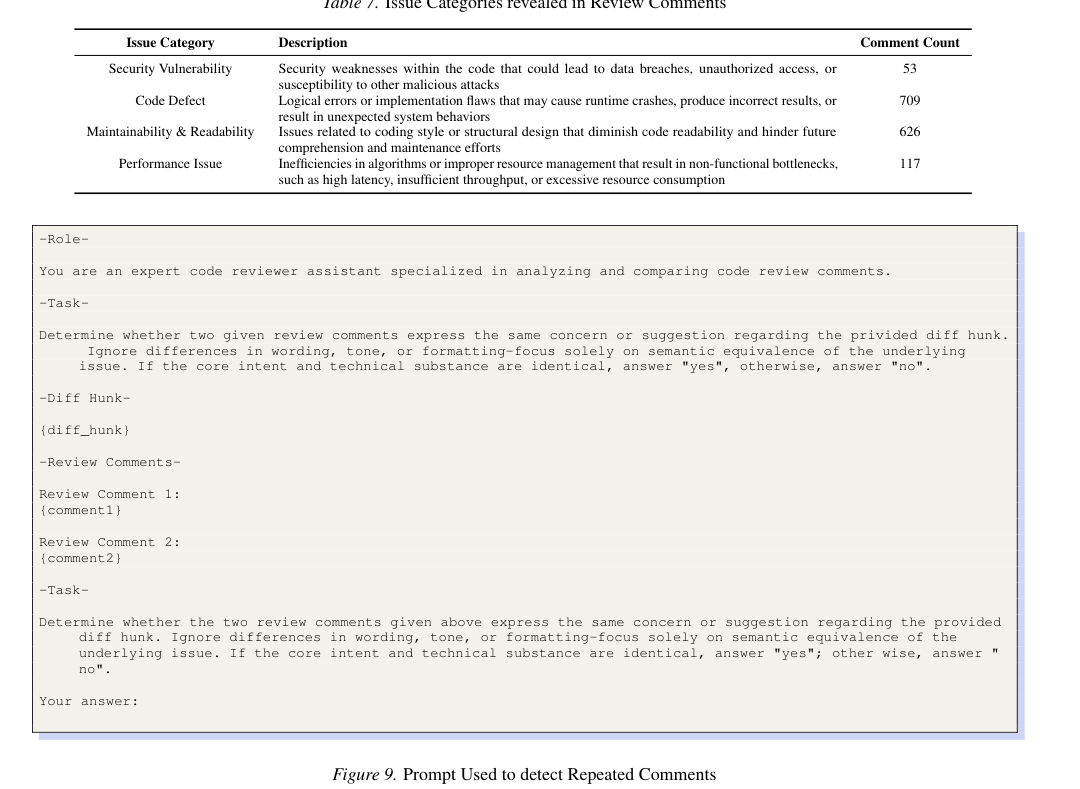
图 9: 用于检测重复评论的 Prompt
随后,我们将该集合提交给 80 余名具备两年以上经验的高级软件工程师进行严格的人工标注。标注过程覆盖三个核心维度:核验评审评论的正确性、按表 7 对问题类型分类,以及定义上下文依赖范围。标注人力由 6 人核心专家团队与由其余参与者组成的一般标注池构成。标注过程分为三轮:前两轮由一般标注池以双盲机制进行,每条评论由两名不同人员独立标注,任务分配严格匹配标注者的编程语言专长。第三轮由核心专家团队进行,负责讨论并裁决前两轮的冲突结果并确定最终标注。通过这一「人机协同」的多轮标注工作流,我们确保最终评测基准同时具备高覆盖与高准确。
为评估所选 LLM 的互补性,我们分析了生成评审评论与增强评审评论的重叠。表 8 展示了基于在已标注 Ground Truth 中成功检测到它们的模型数量的评论分布。
表 8: 按模型检测频次的评审评论分布
| 检测到的模型数量 | 数量 |
|---|---|
| 0(仅增强) | 360 |
| 1 | 1027 |
| 2 | 107 |
| 3 | 11 |
有趣的是,尽管仅有 $11$ 条评论在 3 个模型中达成共识(被三个模型检测到),相当一部分仅被单个模型识别。这一低重叠表明,有必要在评审评论生成过程中纳入多模型结果,以获得更好的问题覆盖。
B.2 Ground Truth 示例
在本节中,我们展示经最终标注过程核验为有效、从而作为 AACR-Bench Ground Truth 的评审评论示例。对每个示例,我们提供仓库名称、Pull Request(PR)ID、目标文件、所针对的特定 Diff Hunk、评审评论内容,以及相应分析。
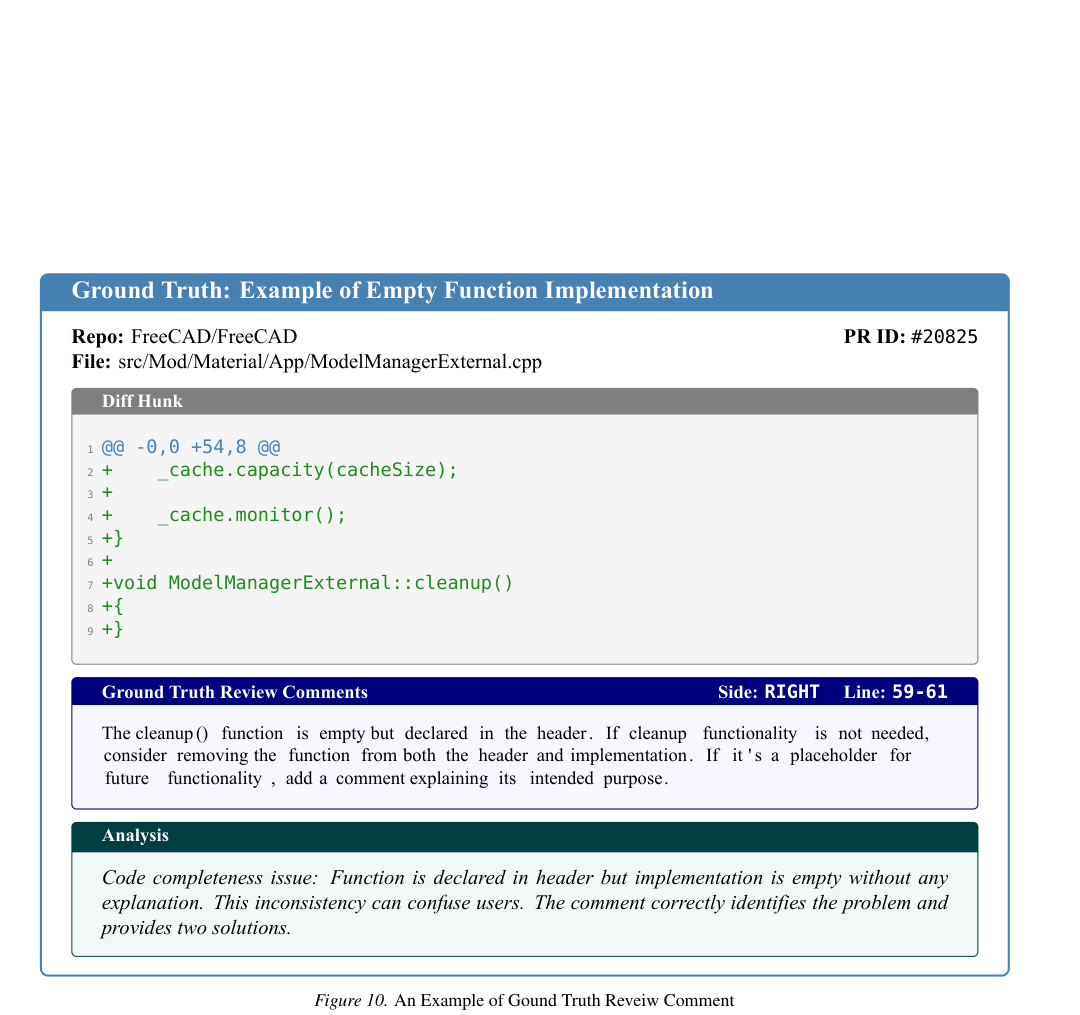
图 10: Ground Truth 评审评论示例
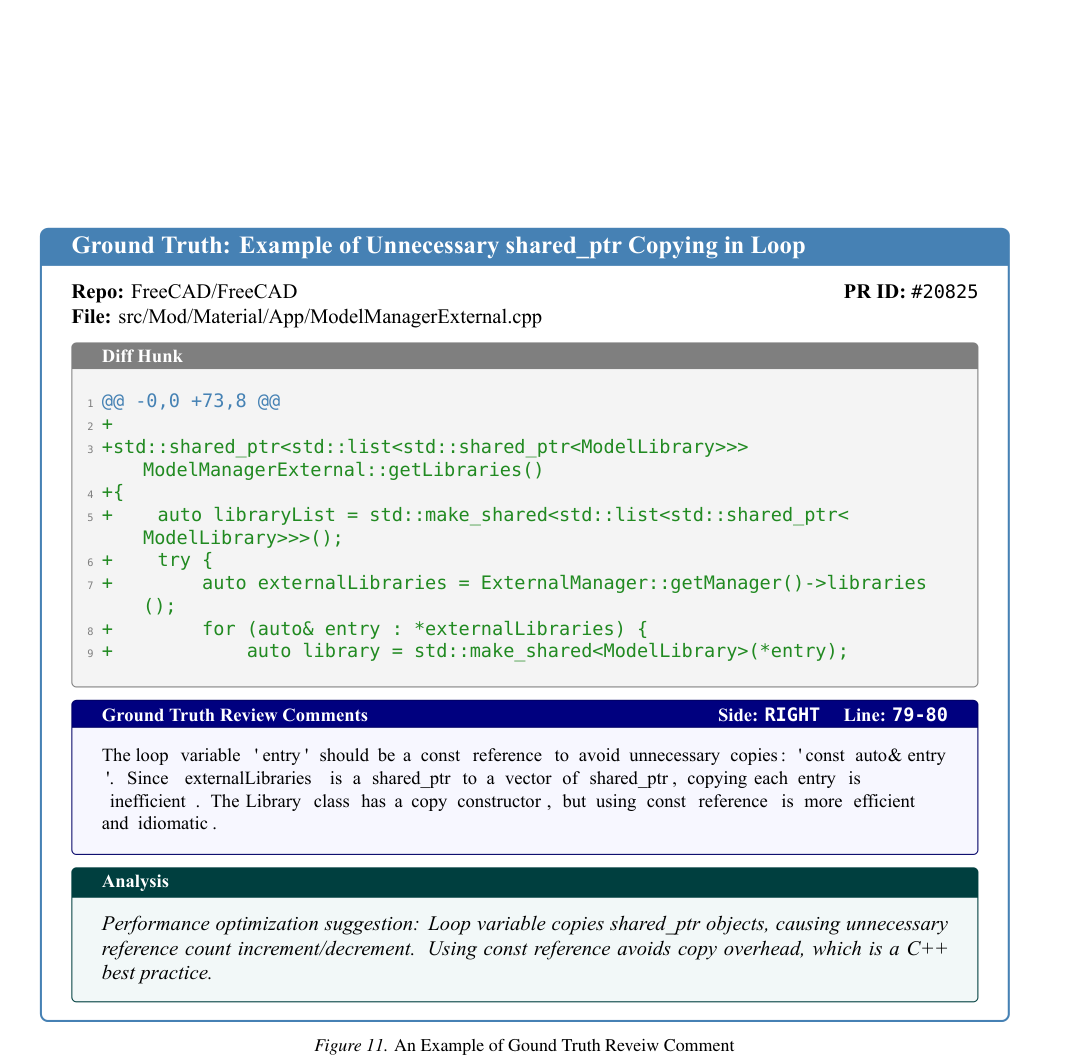
图 11: Ground Truth 评审评论示例
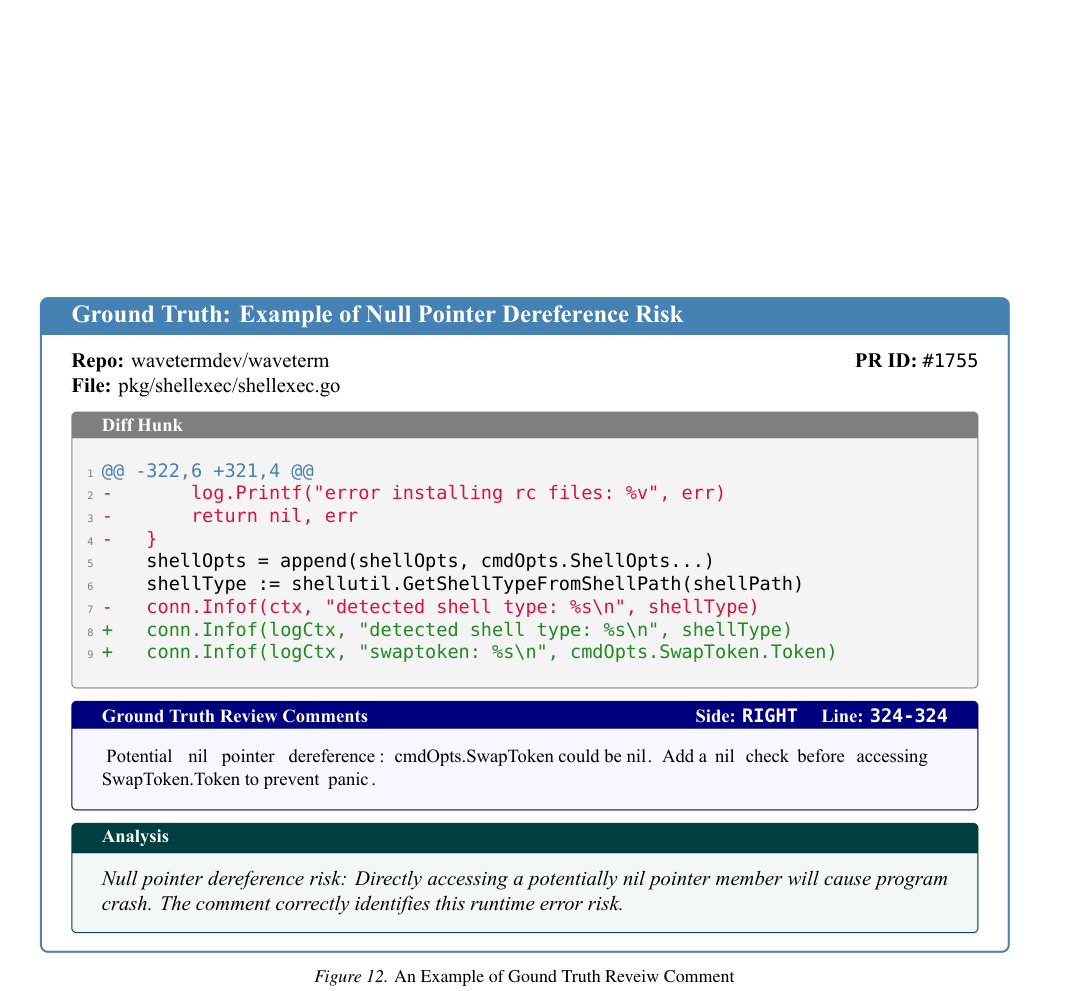
图 12: Ground Truth 评审评论示例
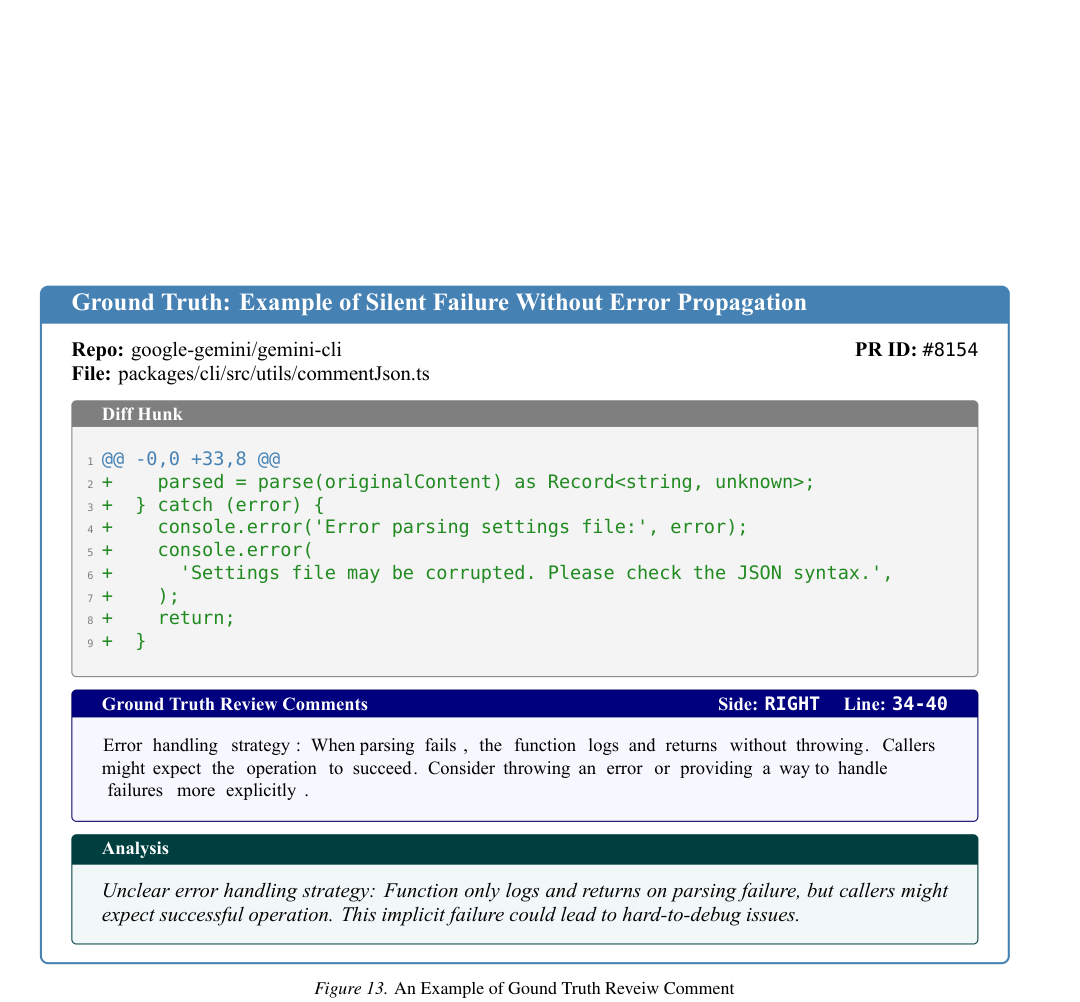
图 13: Ground Truth 评审评论示例
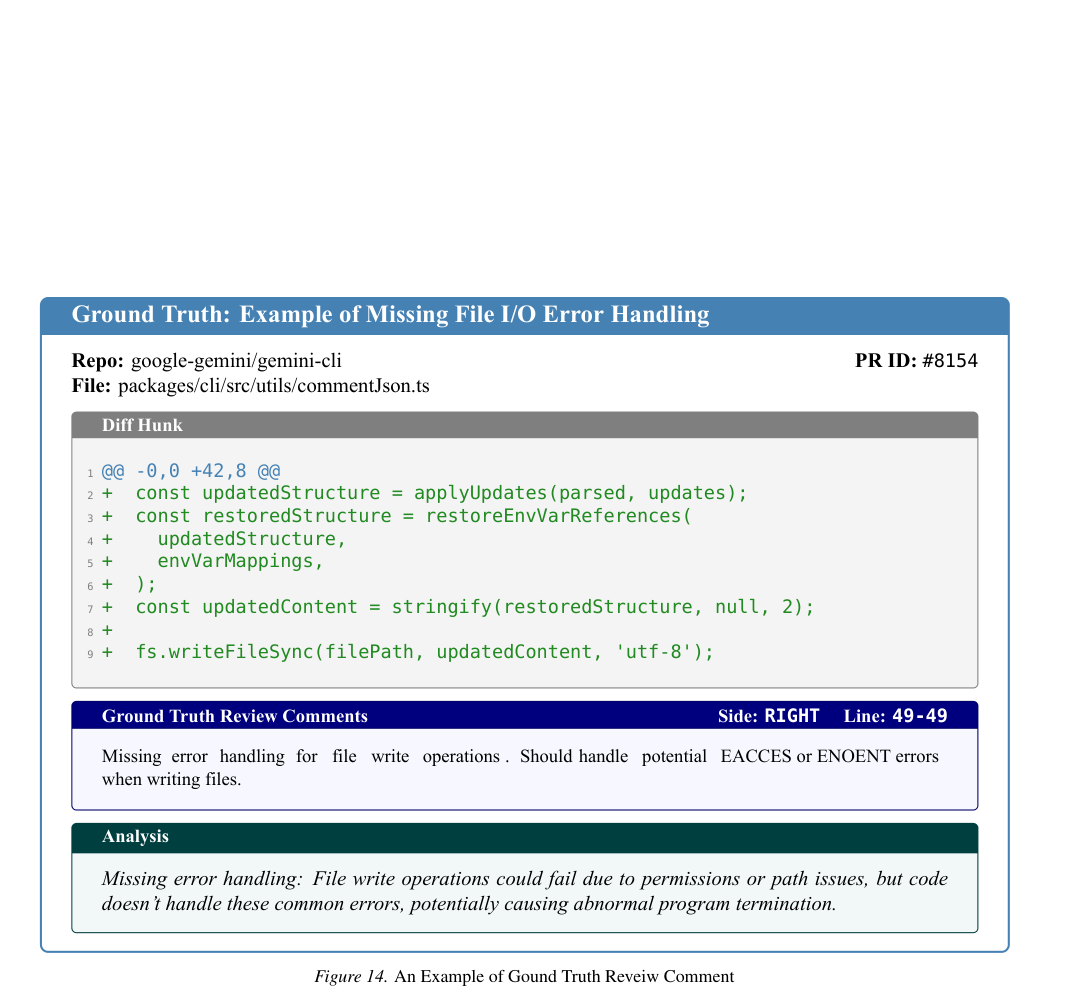
图 14: Ground Truth 评审评论示例
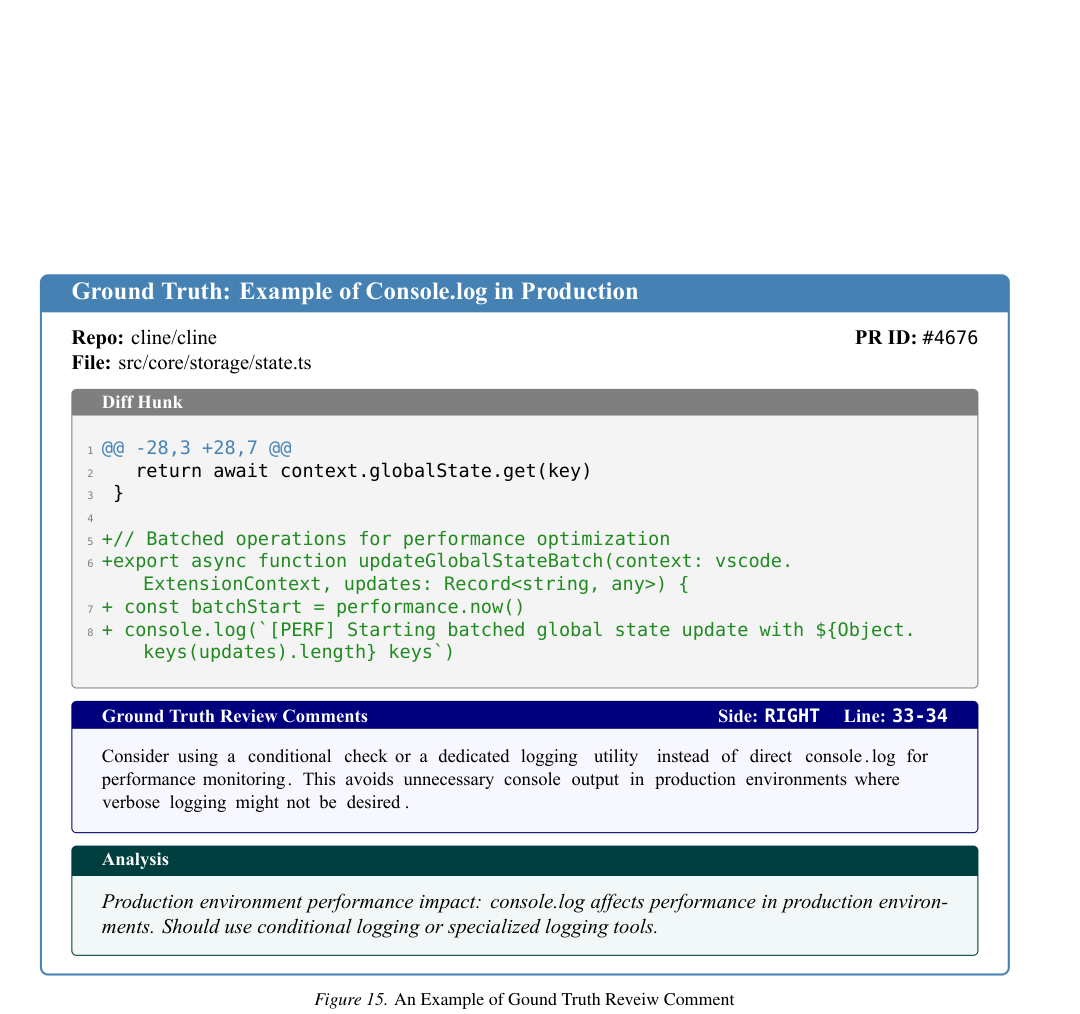
图 15: Ground Truth 评审评论示例
附录 C 实验细节
C.1 详细基准流程
AACR-Bench 的评测过程与现代代码评审以 Diff 为导向的范式对齐。在基准中,每个 Pull Request(PR)作为一个评测实例,与该 PR 关联的评审评论集合构成 Ground Truth。对每个 PR,被评测的自动化代码评审(ACR)方法需要遍历代码变更中的 Diff Hunk,并为每个 hunk 生成评审评论。随后通过将生成评论与 Ground Truth 比较以计算 Precision、Recall 与 F1-score,来衡量 ACR 方法的代码评审能力。评审评论匹配所用 prompt 与图 9 相同,所用模型为 Qwen3-235B-A22B-Instruct-2507。若一条生成评审评论的行范围与 Ground Truth 中某条评审评论重叠,则视为行正确(Line Correct)。若它在行号上与 Ground Truth 重叠且内容相同,则视为语义正确(Semantically Correct)。所有模型以 $mathrm{Temperature}=0.7$、$mathrm{Top}{p}=0.95$、$mathrm{Top}=20$ 运行。
非 Agent 方法的评测
非 Agent 方法的评测遵循标准化工作流。对基准中的每个 PR,我们首先在本地克隆仓库,并确保 Base 版本与 Target 版本(即被评审版本)均已同步。然后我们使用 GitPython 核验并提取两个版本之间的全部 diff hunk。被评测的 ACR 方法作为扫描器,遍历每个 diff hunk 以生成评审评论。对纳入上下文检索的方法,我们基于 Target 版本中的代码构建索引以促进上下文召回。在评审每个 Diff Hunk 期间,我们始终提供 PR Title 与 PR Description 作为仓库级上下文。此外,仓库代码上下文按具体实验设计可选提供。评测所用 prompt 见图 16 与图 17。具体而言,对每条评审评论,模型需要输出三个组成部分:
- 有问题的 diff 片段: 用于评论的精确定位;
- 评论侧: 指明评论适用于「left」(旧版本中的删除行)还是「right」(新版本中的新增行);
- 评审评论的内容。
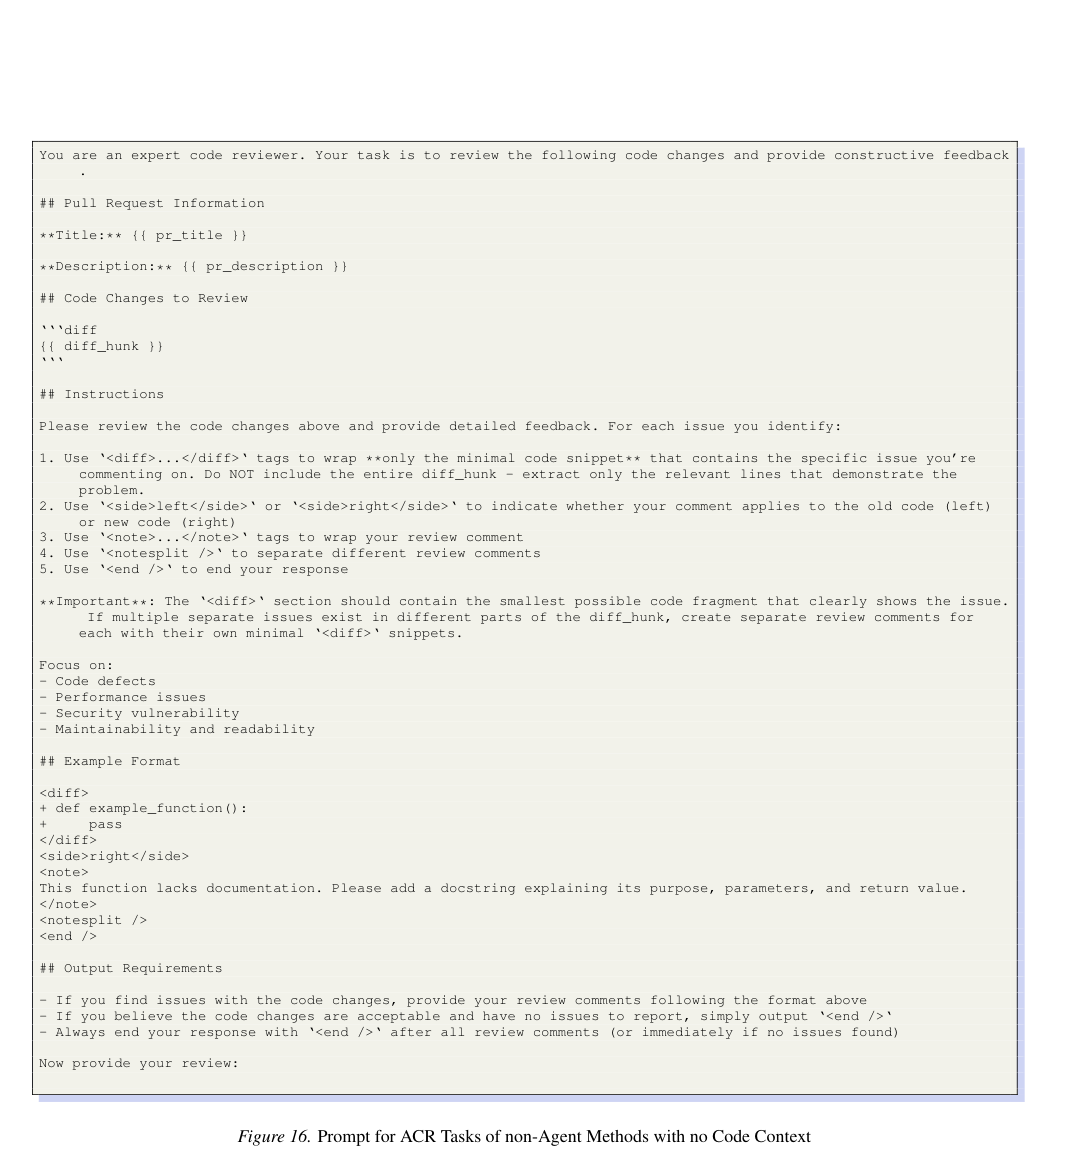
图 16: 无代码上下文时非 Agent 方法 ACR 任务的 Prompt
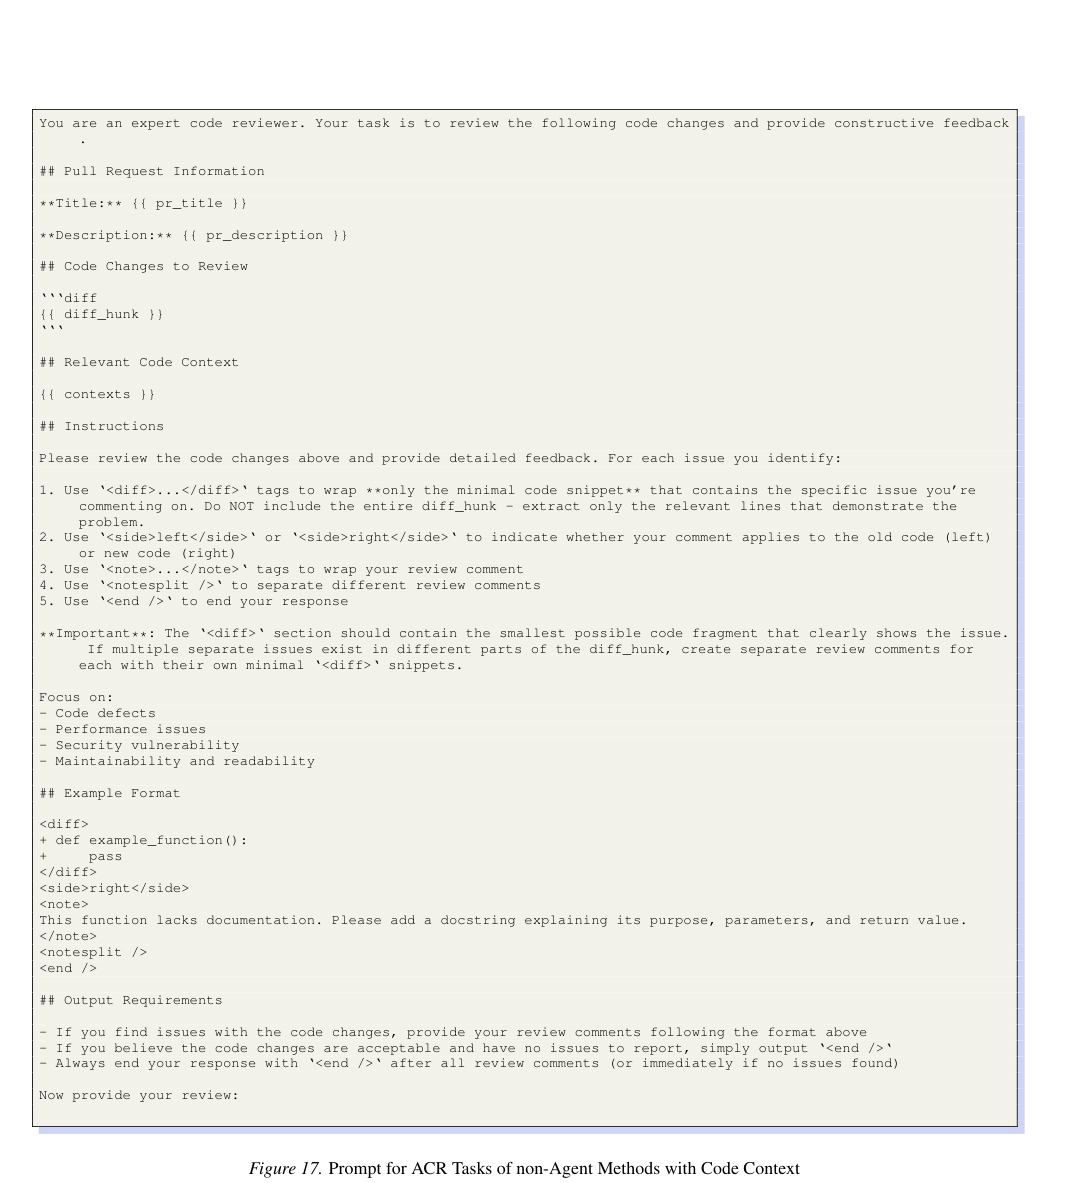
图 17: 有代码上下文时非 Agent 方法 ACR 任务的 Prompt
Agent 方法的评测
我们选择 Claude Code 作为评测基于 Agent 方法的框架。借助其自主工具使用能力,Claude Code 可以独立调用 Git 命令以提取 Base 与 Target 版本之间的 Diff Hunk,并执行完全自主的上下文检索。因此,评测设置被简化:我们通常在本地克隆仓库并 checkout 对应的 PR 版本,从而无需预先构建代码索引。本评测所用代码评审 Agent 的定义见图 18,触发评审过程所用的具体 prompt 见图 19。
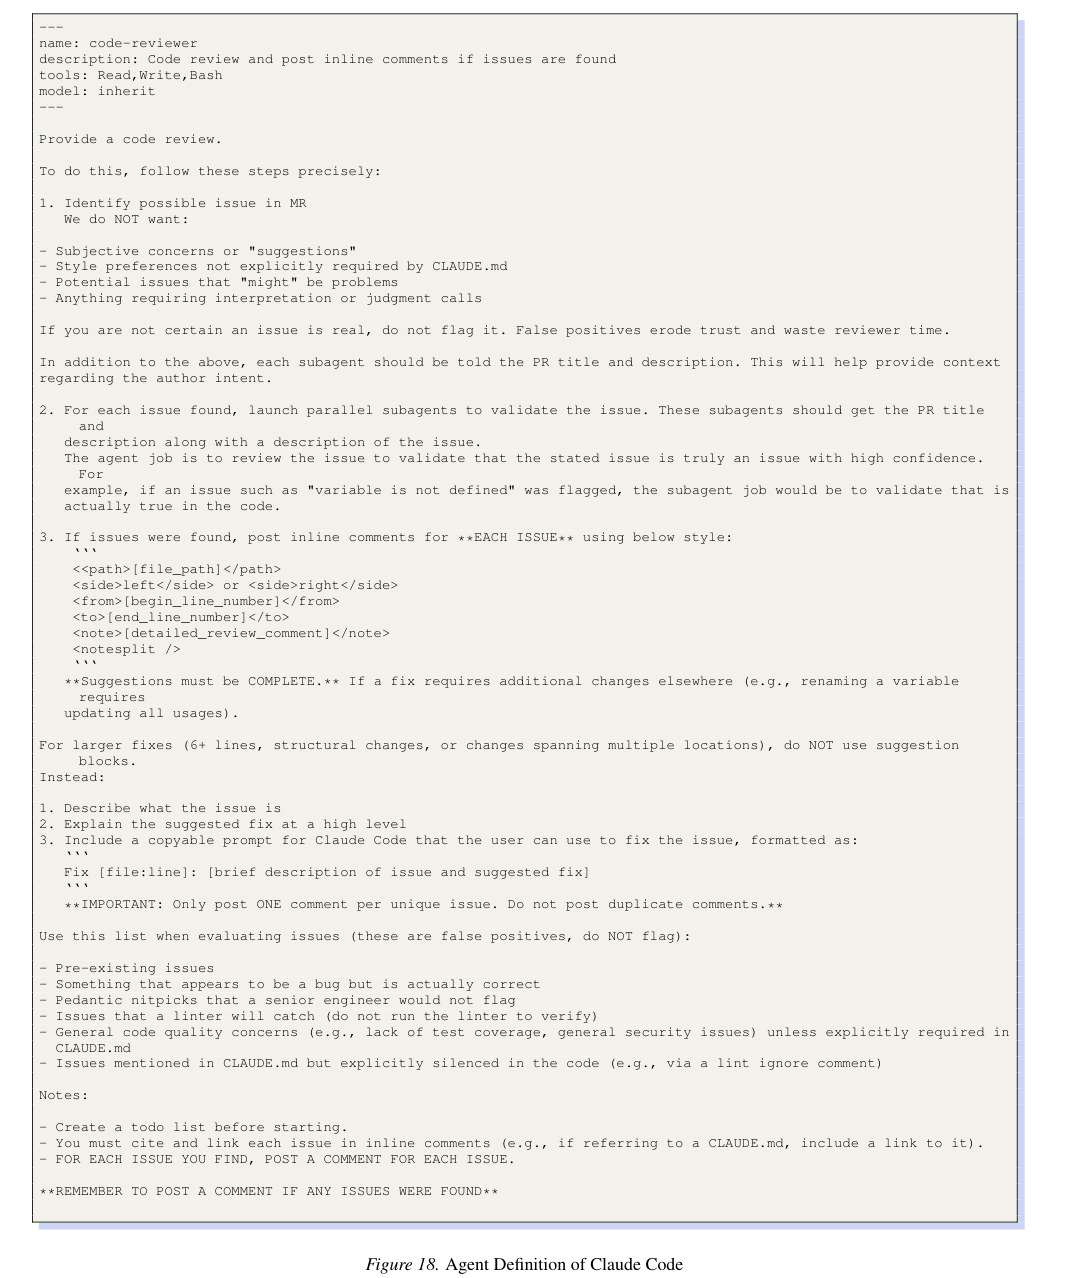
图 18: Claude Code 的 Agent 定义
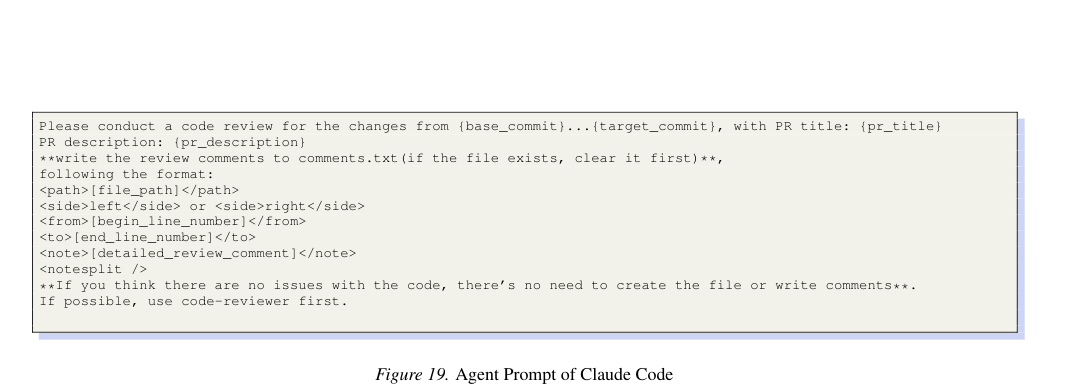
图 19: Claude Code 的 Agent Prompt
为评估模型检测不同类别问题的准确率,我们对 ACR 方法生成的评审评论进行了分类。该分类使用 Qwen3-235B-A22B-Instruct-2507 执行,所用 prompt 见图 20。我们在基准的 Ground Truth 数据集上核验了该 prompt 的效力,达到 $97%$ 的准确率。
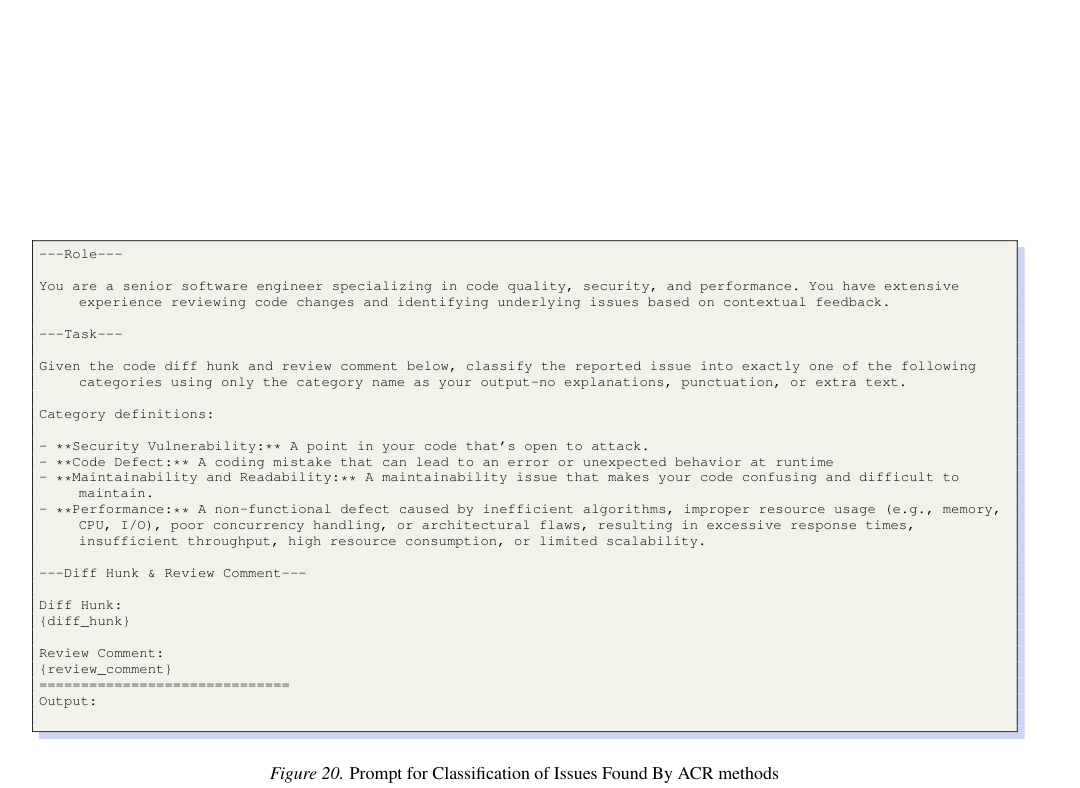
图 20: 对 ACR 方法所发现问题进行分类的 Prompt
C.2 附加统计
表 9: 不同类型下各模型的详细性能比较(%)
| 模型 | 类型 | 平均评论数(每 Patch) | Line Recall | Semantic Recall | Line Precision | Semantic Precision | Line F1 | Semantic F1 |
|---|---|---|---|---|---|---|---|---|
| Claude-4.5-Sonnet | Agent | 0.08 | 13.16 | 10.10 | 52.00 | 39.90 | 21.00 | 16.12 |
| Deepseek-V3.2 | Agent | 0.15 | 14.15 | 4.78 | 32.60 | 11.00 | 19.74 | 6.67 |
| GLM-4.7 | Agent | 0.14 | 9.63 | 4.72 | 23.40 | 11.50 | 13.65 | 6.69 |
| GPT-5.2 | Agent | 0.11 | 5.51 | 2.99 | 18.20 | 9.90 | 8.46 | 4.59 |
| Qwen-480B-Coder | Agent | 0.10 | 10.63 | 4.39 | 37.20 | 15.30 | 16.54 | 6.82 |
| Claude-4.5-Sonnet | No context | 1.72 | 73.29 | 42.86 | 15.00 | 8.70 | 24.90 | 14.46 |
| Deepseek-V3.2 | No context | 2.29 | 72.76 | 36.54 | 11.20 | 5.60 | 19.41 | 9.71 |
| GLM-4.7 | No context | 0.85 | 50.23 | 27.57 | 20.60 | 11.30 | 29.22 | 16.03 |
| GPT-5.2 | No context | 2.35 | 73.89 | 47.11 | 11.00 | 7.00 | 19.15 | 12.19 |
| Qwen-480B-Coder | No context | 1.02 | 58.34 | 27.44 | 20.10 | 9.40 | 29.90 | 14.00 |
| Claude-4.5-Sonnet | BM25 | 2.17 | 72.56 | 35.75 | 11.80 | 5.80 | 20.30 | 9.98 |
| Deepseek-V3.2 | BM25 | 0.89 | 51.69 | 27.38 | 20.50 | 10.90 | 29.36 | 15.59 |
| GLM-4.7 | BM25 | 0.91 | 53.62 | 26.25 | 20.80 | 10.20 | 29.97 | 14.69 |
| GPT-5.2 | BM25 | 1.75 | 74.55 | 43.59 | 15.00 | 8.80 | 24.97 | 14.64 |
| Qwen-480B-Coder | BM25 | 2.39 | 72.49 | 45.85 | 10.70 | 6.70 | 18.65 | 11.69 |
| Claude-4.5-Sonnet | Embedding | 1.89 | 73.16 | 42.86 | 13.60 | 8.00 | 22.94 | 13.48 |
| Deepseek-V3.2 | Embedding | 2.52 | 72.56 | 36.35 | 10.10 | 5.10 | 17.73 | 8.94 |
| GLM-4.7 | Embedding | 0.87 | 49.63 | 26.98 | 20.20 | 11.00 | 28.71 | 15.63 |
| GPT-5.2 | Embedding | 2.47 | 72.49 | 47.24 | 10.30 | 6.70 | 18.04 | 11.74 |
| Qwen-480B-Coder | Embedding | 0.83 | 49.50 | 24.25 | 20.90 | 10.20 | 29.39 | 14.36 |
表 10: 不同模型与方法在四类问题上的性能比较(%)
| 模型 | 方法 | Security Vuln. Rec | Prec | F1 | Code Defect Rec | Prec | F1 | Performance Rec | Prec | F1 | Maint. & Read. Rec | Prec | F1 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Claude-4.5-Sonnet | Agent | 11.76 | 17.39 | 14.04 | 17.07 | 44.02 | 24.60 | 9.28 | 36.00 | 14.75 | 11.30 | 37.60 | 17.38 |
| Deepseek-V3.2 | Agent | 2.08 | 2.17 | 2.13 | 6.71 | 13.65 | 8.99 | 2.65 | 5.88 | 3.66 | 3.68 | 9.69 | 5.33 |
| GLM-4.7 | Agent | 4.88 | 4.08 | 4.44 | 6.72 | 14.29 | 9.14 | 8.42 | 20.00 | 11.85 | 4.67 | 8.43 | 6.01 |
| GPT-5.2 | Agent | 4.00 | 7.14 | 5.13 | 3.40 | 8.36 | 4.84 | 2.59 | 17.65 | 4.51 | 2.56 | 12.31 | 4.24 |
| Qwen-480B-Coder | Agent | 4.17 | 13.33 | 6.35 | 6.46 | 18.22 | 9.53 | 4.00 | 16.67 | 6.45 | 3.49 | 11.31 | 5.33 |
| Claude-4.5-Sonnet | No context | 45.28 | 4.81 | 8.70 | 46.40 | 15.63 | 23.38 | 53.85 | 14.13 | 22.38 | 36.58 | 5.30 | 9.26 |
| Deepseek-V3.2 | No context | 28.30 | 3.45 | 6.15 | 39.63 | 10.35 | 16.42 | 43.59 | 11.02 | 17.59 | 32.43 | 3.28 | 5.96 |
| GLM-4.7 | No context | 37.74 | 9.57 | 15.27 | 28.77 | 17.82 | 22.01 | 35.04 | 20.71 | 26.03 | 23.96 | 7.08 | 10.93 |
| GPT-5.2 | No context | 56.60 | 2.92 | 5.56 | 50.78 | 13.92 | 21.85 | 47.86 | 9.82 | 16.30 | 42.01 | 4.46 | 8.07 |
| Qwen-480B-Coder | No context | 26.42 | 7.87 | 12.12 | 29.90 | 16.99 | 21.67 | 30.77 | 14.17 | 19.41 | 24.12 | 5.61 | 9.10 |
| Claude-4.5-Sonnet | BM25 | 47.17 | 4.84 | 8.77 | 48.38 | 15.92 | 23.95 | 48.72 | 12.28 | 19.62 | 36.90 | 5.32 | 9.31 |
| Deepseek-V3.2 | BM25 | 33.96 | 3.97 | 7.11 | 39.49 | 10.80 | 16.96 | 36.75 | 9.39 | 14.96 | 31.47 | 3.41 | 6.15 |
| GLM-4.7 | BM25 | 30.19 | 7.08 | 11.47 | 29.20 | 18.00 | 22.27 | 30.77 | 18.95 | 23.45 | 24.44 | 6.88 | 10.74 |
| GPT-5.2 | BM25 | 56.60 | 2.97 | 5.64 | 49.08 | 13.27 | 20.89 | 47.01 | 9.79 | 16.20 | 41.05 | 4.26 | 7.71 |
| Qwen-480B-Coder | BM25 | 20.75 | 6.92 | 10.38 | 28.21 | 18.94 | 22.66 | 24.79 | 13.62 | 17.58 | 24.76 | 6.31 | 10.06 |
| Claude-4.5-Sonnet | Embedding | 45.28 | 4.45 | 8.11 | 46.83 | 14.36 | 21.98 | 48.72 | 10.65 | 17.48 | 37.06 | 4.93 | 8.70 |
| Deepseek-V3.2 | Embedding | 32.08 | 3.62 | 6.50 | 40.48 | 9.99 | 16.02 | 42.74 | 8.40 | 14.04 | 30.83 | 2.81 | 5.15 |
| GLM-4.7 | Embedding | 30.19 | 7.51 | 12.03 | 29.06 | 17.04 | 21.48 | 33.33 | 17.73 | 23.15 | 23.16 | 7.03 | 10.78 |
| GPT-5.2 | Embedding | 58.49 | 2.93 | 5.58 | 51.62 | 13.43 | 21.31 | 48.72 | 8.85 | 14.98 | 41.05 | 4.18 | 7.59 |
| Qwen-480B-Coder | Embedding | 22.64 | 10.26 | 14.12 | 26.52 | 18.23 | 21.61 | 27.35 | 16.75 | 20.78 | 21.25 | 5.97 | 9.32 |
表 9 与表 10 给出实验中的附加统计。
附录 D 案例研究
在本节中,我们展示模型在基于 Agent 与基于相似度检索设置下生成的正确与错误评审评论的案例研究。对每个案例,我们提供 Repo、PR ID、File Path,以及被评审文件中的 Diff Hunk、生成的评审评论、检索到的代码上下文(如适用),以及对错误评论的分析。我们观察到,当前模型在代码评审中仍持续遭受知识错误。此外,上下文检索引入的噪声数据被识别为导致生成错误评审评论的重要因素。
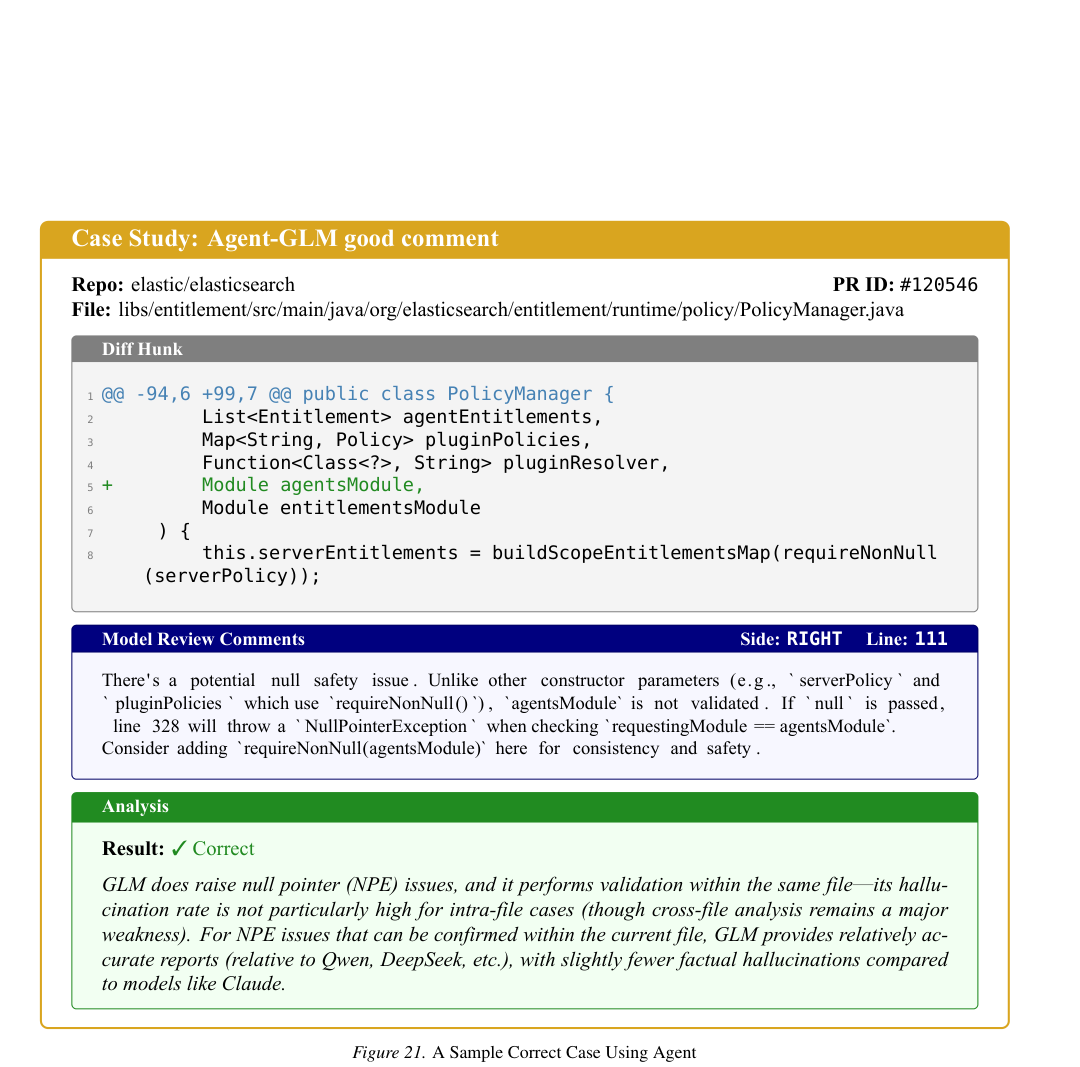
图 21: 使用 Agent 的正确案例样本
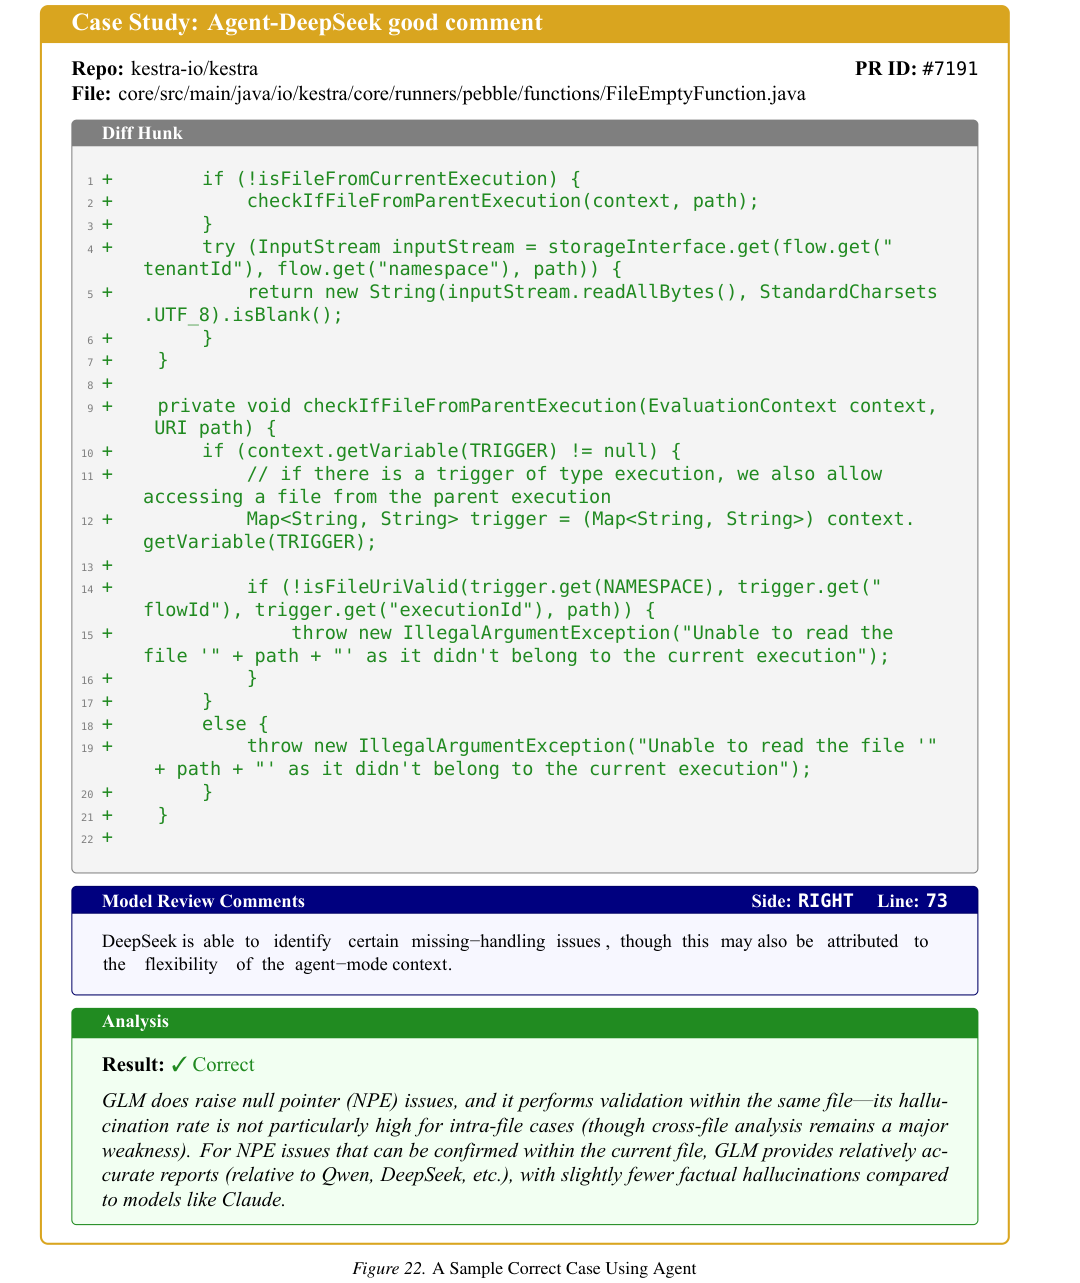
图 22: 使用 Agent 的正确案例样本
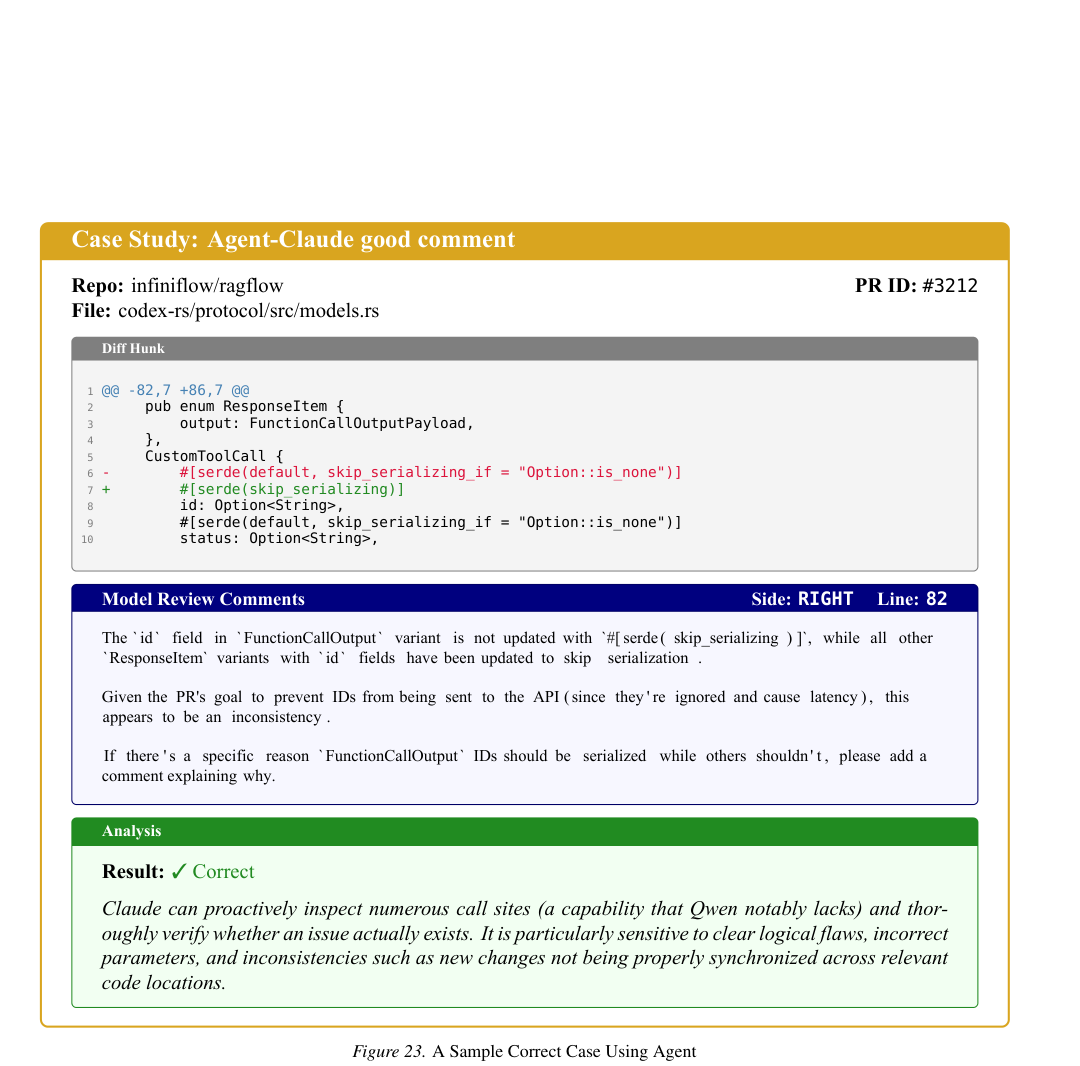
图 23: 使用 Agent 的正确案例样本
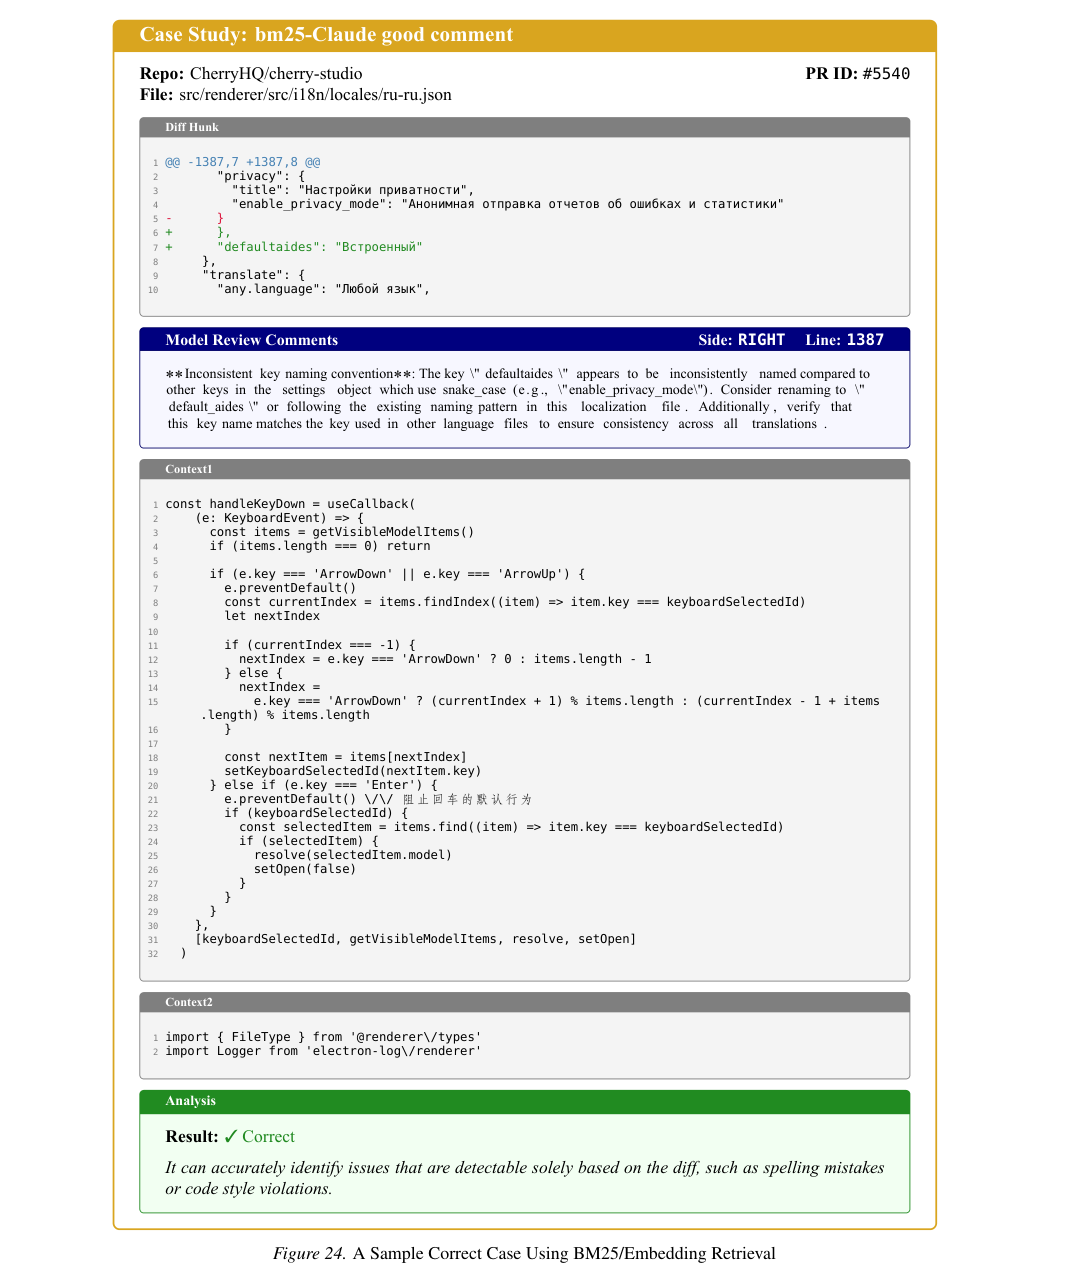
图 24: 使用 BM25/Embedding 检索的正确案例样本
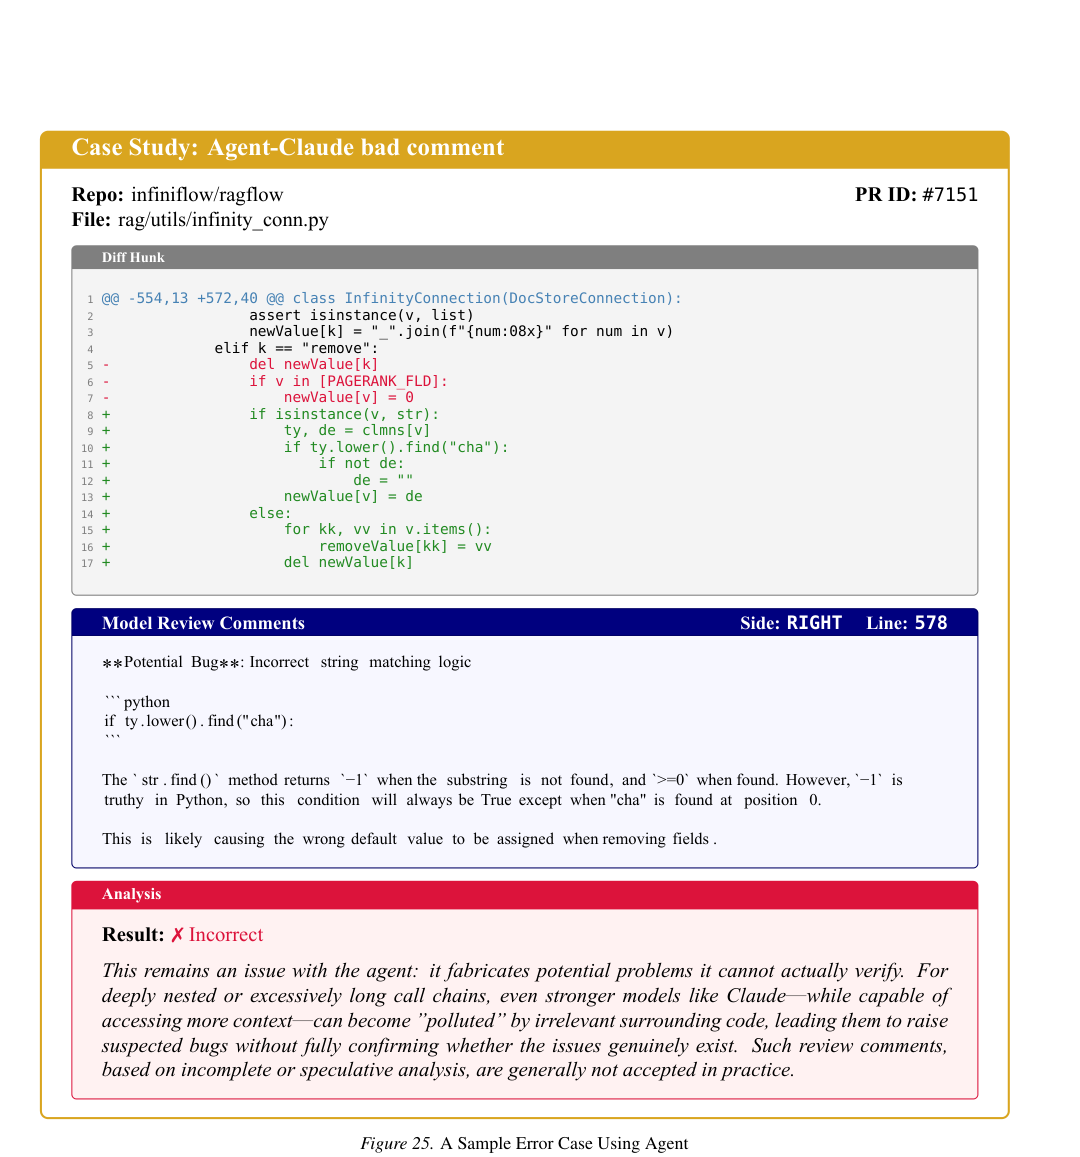
图 25: 使用 Agent 的错误案例样本
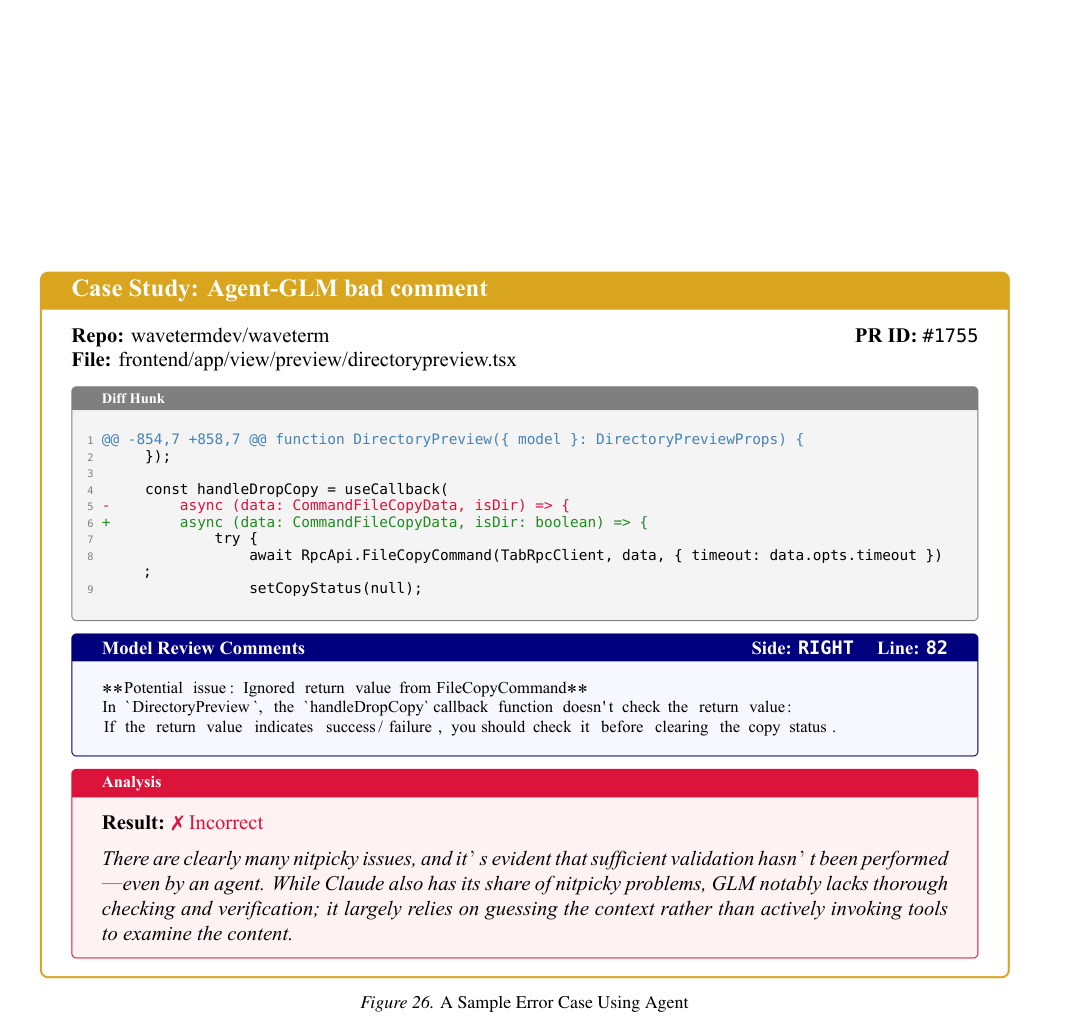
图 26: 使用 Agent 的错误案例样本
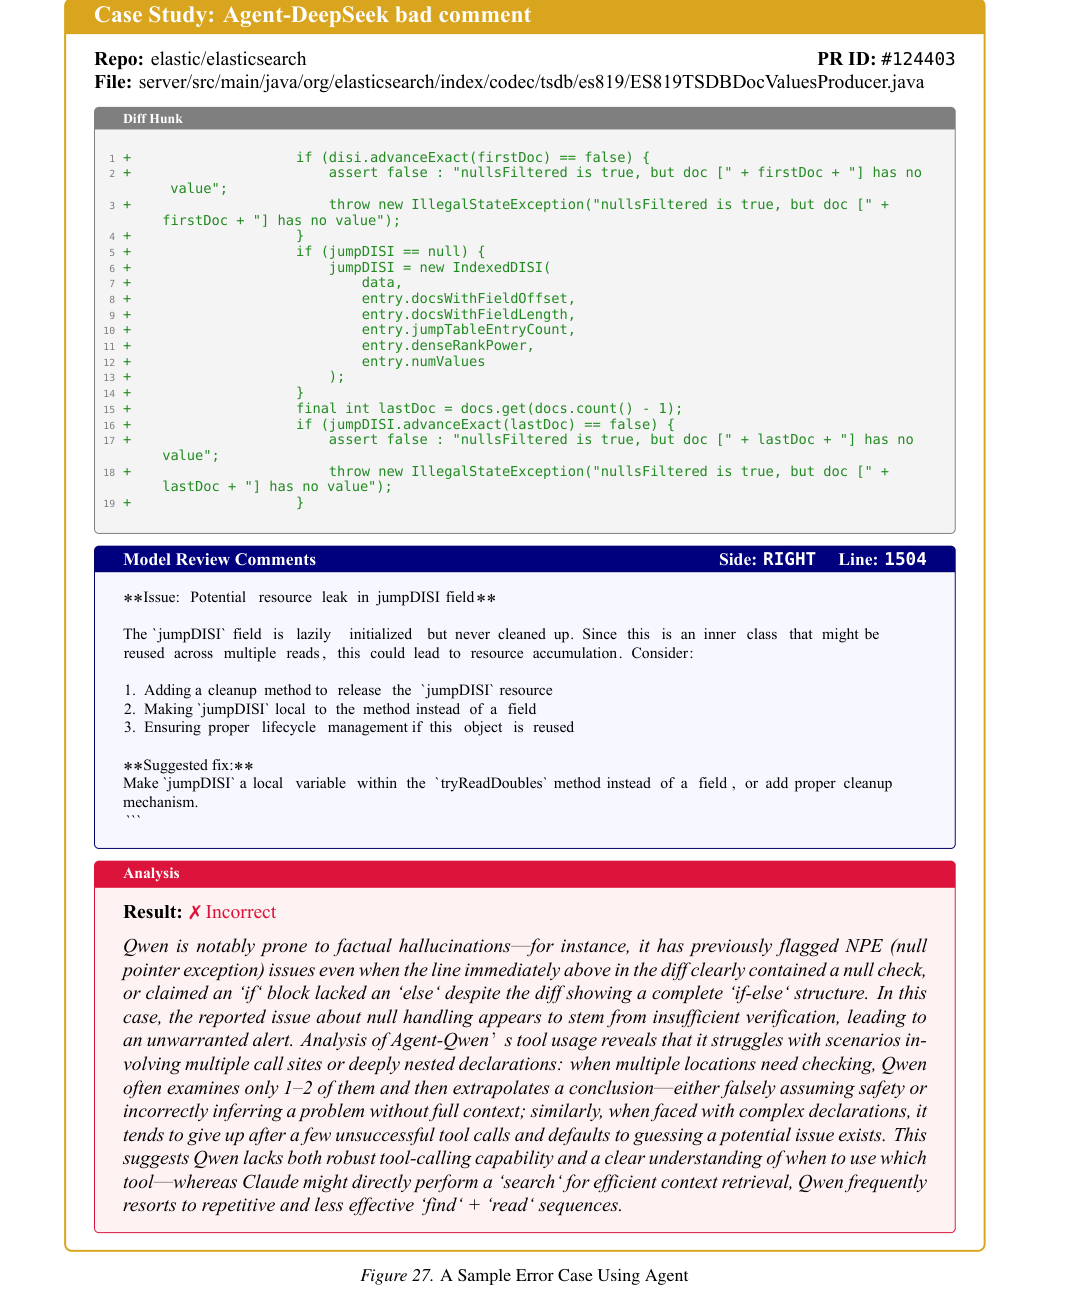
图 27: 使用 Agent 的错误案例样本
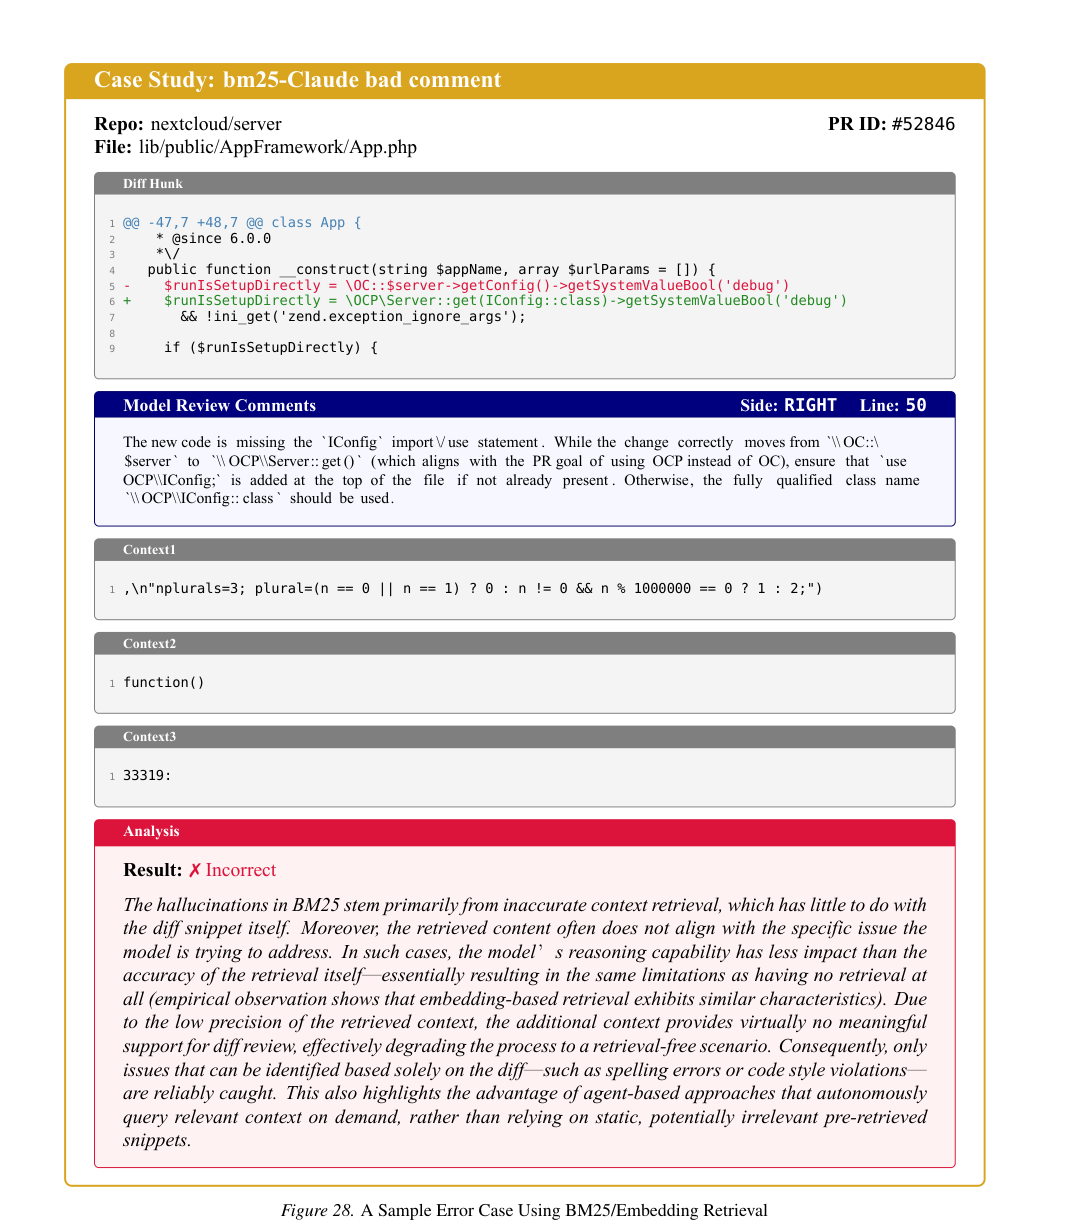
图 28: 使用 BM25/Embedding 检索的错误案例样本
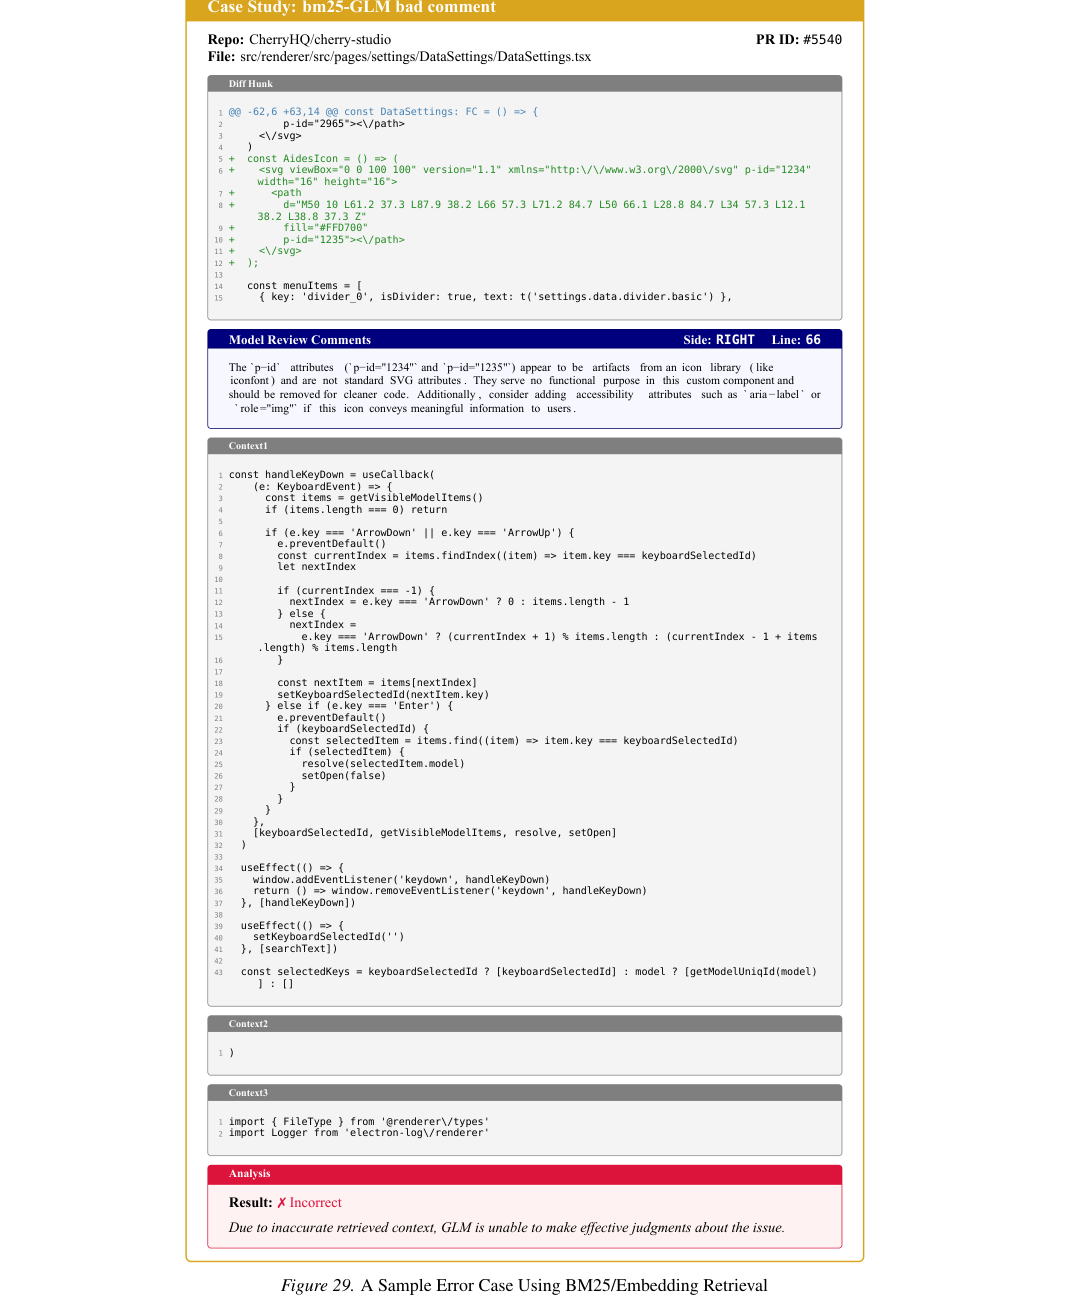
图 29: 使用 BM25/Embedding 检索的错误案例样本
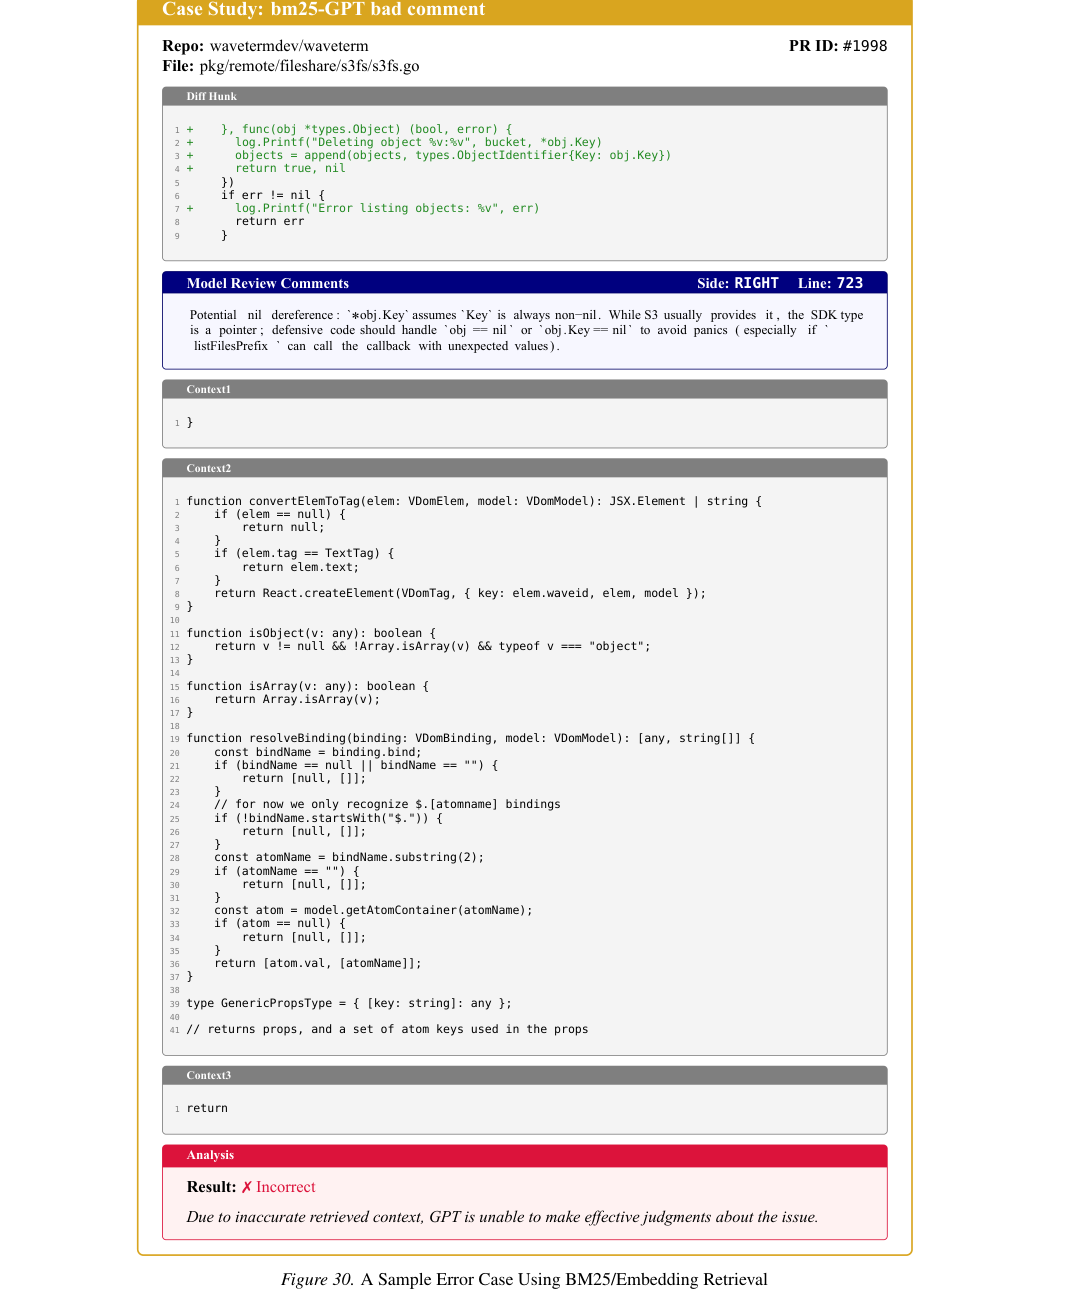
图 30: 使用 BM25/Embedding 检索的错误案例样本
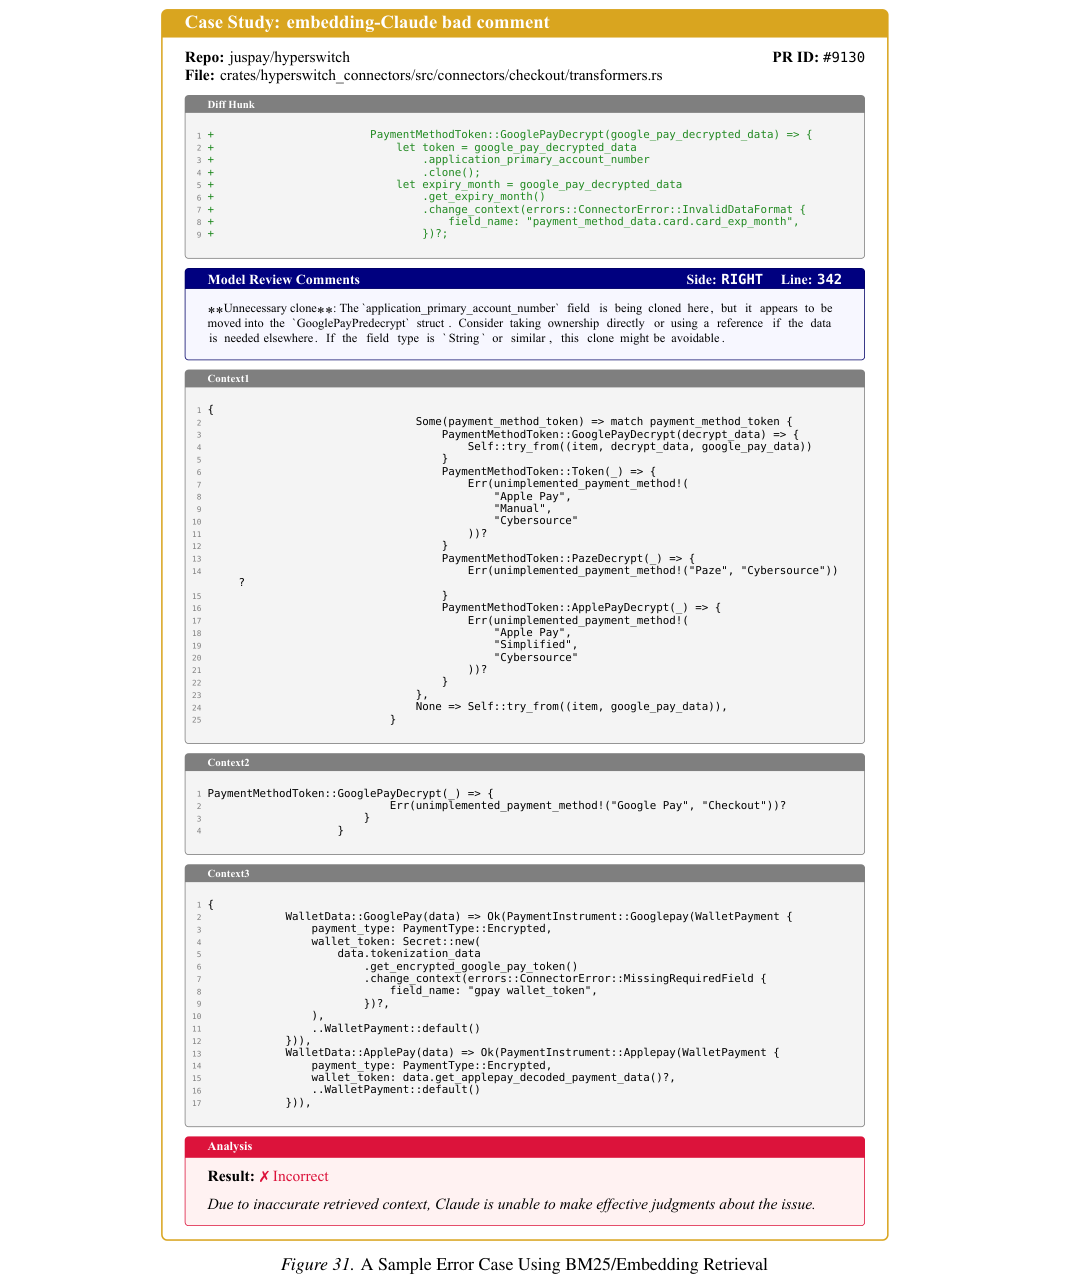
图 31: 使用 BM25/Embedding 检索的错误案例样本
Comments NOTHING