
Meta Data
- 发表时间:2024-12-24
- 作者:Umut Cihan, Vahid Haratian, Arda İçöz, Mert Kaan Gül, Ömercan Devran, Emircan Furkan Bayendur, Baykal Mehmet Uçar, Eray Tüzün(比尔肯特大学、倍科)
- 论文链接:https://arxiv.org/pdf/2412.18531.pdf
- arXiv 页面:https://arxiv.org/abs/2412.18531
- 项目链接:https://doi.org/10.5281/zenodo.13917481
实践中的自动化代码评审
原文标题:Automated Code Review In Practice
Umut Cihan*, Vahid Haratian*, Arda İçöz*, Mert Kaan Gül†, Ömercan Devran†, Emircan Furkan Bayendur†, Baykal Mehmet Uçar†, Eray Tüzün*
* 比尔肯特大学(Bilkent University),安卡拉,土耳其
† 倍科(Beko),伊斯坦布尔,土耳其
摘要
背景: 代码评审(code review)是实践者广泛采用的做法,用于提升软件质量并传递知识。由于需要人工投入,且可能拖慢开发进度,它常被视为耗时。若干 AI 辅助代码评审工具(Qodo、GitHub Copilot、Coderabbit 等)利用大语言模型(LLM)提供自动化评审。这类工具在工业场景中的总体效果尚待检验。
目标: 本研究考察基于 LLM 的自动化代码评审工具在工业环境中的影响。
方法: 研究在一家已采用 AI 辅助代码评审工具(基于开源 Qodo PR Agent)的工业软件开发环境中开展。10 个项目中共 238 名实践者可以使用该工具。我们重点分析了其中 3 个项目,涵盖 4,335 个 pull request,其中 1,568 个经过了自动化评审。数据收集主要来自三方面:(1)对 pull request 数据的定量分析,包括标明开发者是否采纳自动化评论的评论标签;(2)就单个 pull request 上的评审体验向开发者发放问卷;(3)对 22 名实践者的更广泛调查,收集其对自动化代码评审的总体看法。
结果: 73.8% 的自动化代码评审评论被标记为已解决(Resolved)。然而,pull request 的总体平均关闭时长从 5 小时 52 分钟增加到 8 小时 20 分钟,不同项目趋势不一。问卷显示,多数实践者认为自动化代码评审仅带来代码质量的轻微改善。
结论: 基于 LLM 的自动化代码评审工具在软件开发中被证明有用,能够加强缺陷发现、提高代码质量意识并推广最佳实践。但它也拉长了 pull request 关闭时间,并带来错误评审、不必要的修改以及不相关评论等弊端。基于这些发现,我们讨论了实践者如何更有效地使用自动化代码评审技术。
索引词: 代码评审,大语言模型,pull request,AI 辅助代码评审,工业案例研究,代码评审自动化
I 引言
代码评审是一种质量保证过程,工业界有不同变体,由开发者互相检查彼此的代码变更 [1]。它源于正式的代码审查(formal code inspections)[2],随后演化为更轻量的过程,常被称为现代代码评审(Modern Code Review, MCR)[3]。MCR 的特点是非正式、基于工具、且定期进行 [4]。该过程的常见收益包括知识共享、学习、缺陷识别与代码改进 [5], [6]。
为进行代码评审,开发者需要花时间理解他人的工作及其在整体项目中的位置。开源软件(OSS)开发者自报每周平均花费 6.4 小时做代码评审 [7],而 Google 的案例研究显示更低,为 3.2 小时 [6]。这些数字表明开发者在评审上投入了相当多时间。
由于工作负荷,开发者常常推迟代码评审任务,从而推迟代码变更的合并。在同一项 Google 案例研究中,合并批准的中位时间不到 4 小时,大型变更集则为 5 小时 [6]。多家公司报告了更高的中位批准时间:Google Chrome 15.7 小时、Google 的 Android 20.8 小时、AMD 17.5 小时,以及微软的 Bing 14.7 小时、SQL 19.8 小时、Office 18.9 小时 [8]。批准时间的差异说明公司与项目之间存在不同。然而,关键代码变更延误的实际成本并未反映在中位数或平均值中,可能更具破坏性。在一项针对微软开发者的研究中,「及时获得反馈」被列为代码评审实践的首要挑战 [5]。
自动化有可能缩短代码批准时间并减轻开发者的人工负担。为此,已有多项尝试自动化代码评审过程 [9]–[19],主要集中在评审人指派 [20]。这些工作包括生成代码评审的工具 [10]–[12]、预测代码变更是否会被批准 [21], [22],以及根据评审修复代码 [23], [24]。本研究关注的是代码评审生成的自动化。
为生成代码评审,开发者需要花时间理解代码变更、寻找错误、发现性能瓶颈或对编码规范的偏离。已有若干基于预训练模型提供代码评审的尝试 [21], [22], [25]。ChatGPT [26] 推出后,自动化代码评审生成出现了大量努力 [27]。若干具备代码评审能力的工具被创建,通常使用 OpenAI 的 LLM,如 GPT-4 [28], [29]。
自动化代码评审工具在工业界的使用日益增多 [27]。然而,关于其潜在收益的实证证据仍然不足。例如,自动化评审节省的时间可能被其引入的新问题抵消。此外,减少开发者投入所带来的财务收益,相比运行这类工具的成本可能微不足道。为填补这一研究空白,我们开展研究以回答下列问题:
- RQ1: 基于 LLM 的自动化代码评审在软件工业情境中有多大用处?
- RQ2: 基于 LLM 的自动化代码评审如何影响 pull request 关闭过程的节奏?
- RQ3: 引入基于 LLM 的自动化代码评审如何影响人工代码评审活动的数量?
- RQ4: 开发者如何看待基于 LLM 的自动化代码评审工具?
我们与倍科(Beko)合作。倍科是一家跨国家电公司,其软件部门采用了基于开源 Qodo(原 CodiumAI)PR Agent [29]、使用 GPT-4 Turbo 模型 [30] 的自动代码评审工具。该工具为 10 个项目、22 个项目仓库中的每个 pull request 提供自动代码评审评论。
数据收集包括三个来源。首先,我们从托管项目仓库的版本控制系统与开发平台 Azure DevOps 提取数据,涵盖 pull request 信息、评审评论、评审评论标签,以及 pull request 初始版本与最终版本的对比。开发者被要求为每条评审评论打标签,以标明是否已将建议落实到代码中。其次,作者会就每个 pull request 收到一份简短问卷。最后,我们对 22 名实践者进行了更广泛的调查,以收集总体看法。
II 相关工作
代码评审需要开发者投入大量精力与时间 [5], [7]。这些需求,再加上频繁的上下文切换,推动了自动化 [31]。代码评审自动化是研究中被充分探讨的部分,其中大部分工作处理评审人指派问题 [32]–[40]。其他代码评审环节也有相当投入。2018 年,Gupta 等人 [25] 提出用有监督深度学习将历史评审与代码片段匹配。2019 年,Li 等人 [22] 提出基于卷积神经网络(CNN)的模型,Shi 等人 [21] 提出利用 CNN 与 LSTM 的框架,用于预测代码变更是否会被批准。2022 年,Thongtanunam 等人 [24] 提出在代码评审过程中自动修改源代码的模型。
除上述工作外,代码评审生成的自动化还考察了多种技术,包括信息检索 [9]、预训练模型 [10]–[12]、LLM [13]–[15]、LLM prompt 微调 [16]、用人类反馈微调 LLM [17],以及 LLM agent [18], [19]。Tufano 等人 [20] 考察了当时最先进的代码评审自动化效果。他们研究了基于预训练 Text-To-Text Transfer Transformer(T5)的模型 [11], [41]、用信息检索推荐代码评审的 CommentFinder [9]、使用预训练技术的 CodeReview Model [10],以及未指明版本的 ChatGPT [26]。他们发现 ChatGPT 可作为改进代码的有竞争力基线,无论是直接的 code-to-code 变换,还是基于评论生成代码(comment-to-code)。相比之下,ChatGPT 在评论生成(code-to-comment)上并未超过当时的最先进方法。
将 LLM 与生成式人工智能用于代码评审生成也吸引了其他研究。Davila 等人 [27] 对生成式人工智能用于代码评审的灰色文献做了综述,展示了 ChatGPT 一类基于 LLM 的工具如何被探索用于代码评审。Fan 等人 [14] 考察了 LLM 在三项与代码变更相关的任务上的能力:代码评审生成、commit message 生成,以及即时评论更新。他们的结论是 LLM 在这些任务上很有前景。Watanabe 等人 [42] 调查了 179 个 GitHub 项目中 229 条包含 ChatGPT 对话链接的评审评论。分析显示,对 ChatGPT 回答的反应中有 30.7% 为负面,开发者常称其缺少额外收益。2024 年,来自 Google 与华盛顿大学的 Vijayvergiya 等人 [15] 展示了 AutoCommenter 的开发与大规模工业落地。AutoCommenter 是面向四种编程语言(C++、Java、Python 和 Go)的 LLM 支持的自动化代码评审系统。他们的发现表明,在获得较高终端用户接受度的同时,开发端到端自动化代码评审系统是可行的。
本研究旨在填补关于自动化代码评审工具对软件开发影响的纵向研究不足。与以往研究不同,我们考察商用、基于 LLM 的自动化代码评审工具 [29] 在真实工业环境中对开发产物与开发者感知的影响。本研究希望为实践者提供关于是否以及如何采用基于 LLM 的自动化代码评审工具的有价值见解。
III 研究设置
本研究通过评估性案例研究,评估基于 LLM 的自动化代码评审对软件开发的影响。我们评估其有效性、对 pull request 关闭速度的影响,以及人工代码评审数量的变化。本节介绍研究设置。第 III-A 节介绍研究对象。第 III-B 节给出研究目标与研究问题。本研究同时包含定量与定性数据。第 III-C 节描述如何从项目仓库收集定量数据。第 III-D 节描述通过问卷进行的定性数据收集。第 III-E 节描述我们对研究问题的处理方式。
III-A 研究对象
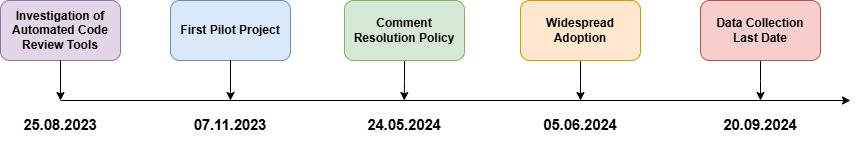
图 1: 数据收集时间线
我们在跨国企业倍科的软件开发部门开展研究。该公司经营耐用消费品与电子产品。倍科软件开发部门负责面向客户与员工的软件,共有 238 名实践者。
图 1 概述了倍科落地 CodeReviewBot 的历程:始于 2023 年 8 月 25 日的调研阶段,驱动因素是提升代码质量与效率。倍科评估了若干开源项目,包括 CodeRabbit [28]、Qodo(原 CodiumAI)[29],以及流水线扩展类工具,如 Reviewbot^1、ChatGPT-CodeReview^2 和 Codereview.gpt^3。经审慎考虑,倍科选择了 Qodo PR-Agent [29],因其性能高且集成顺畅。他们按自身需求定制功能,并在内部命名为 “Code Review Bot”。后文为便于阅读,统一使用 “CodeReviewBot”。第一个试点项目于 2023 年 11 月 7 日上线。到 2024 年 6 月 5 日,倍科已在 10 个项目、22 个仓库中采用 CodeReviewBot。2024 年 5 月 24 日,实践者通过邮件活动获知评论解决策略(commit/comment resolution policy)已生效;2024 年 9 月 20 日是本研究的最终数据收集日。图 2 给出一条 CodeReviewBot 评论示例。
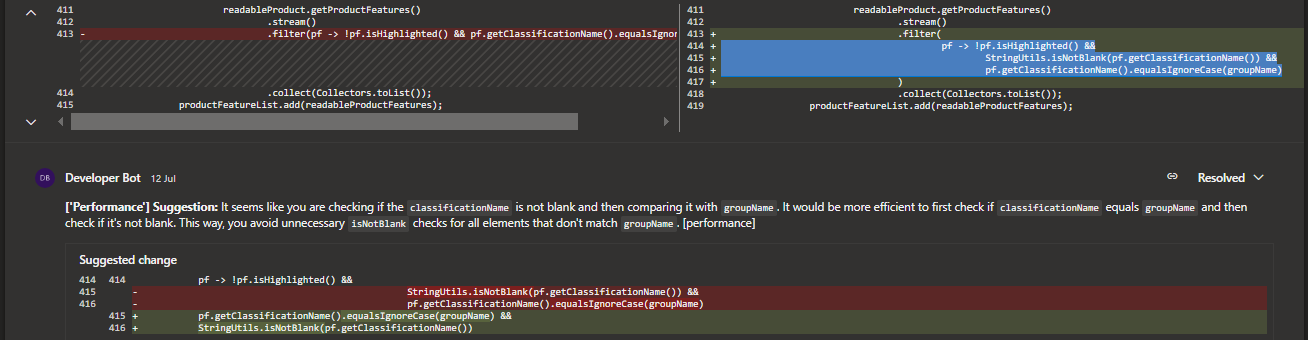
图 2: CodeReviewBot 评审示例
CodeReviewBot 使用 GPT-4-32K 模型,为每个 pull request 提供自动代码评审评论。该工具补充代码评审过程;开发者仍可添加自己的评审。图 3 描绘了 pull request 流程。该工具运行在跨越 10 个不同项目的 22 个仓库上。这些仓库包含 Java、JavaScript、C、HTML、SQL、C# 和 TypeScript 代码。
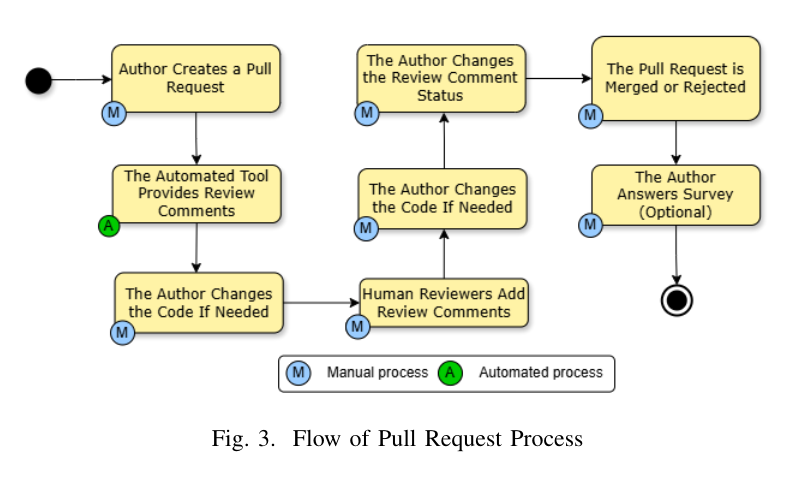
图 3: Pull Request 流程
表 I: 纳入本研究的项目
| 项目 | 说明 | 开发者人数 | 语言 |
|---|---|---|---|
| Project #1 | B2B 电商门户 | 21 | TypeScript, Java, JavaScript |
| Project #2 | 企业管理平台 | 51 | HTML, JavaScript, C# |
| Project #3 | 可定制 AI 解决方案中心 | 22 | C#, HTML, JavaScript, SQL |
选择倍科作为研究对象,是因为他们已使用 CodeReviewBot 相当长时间。开发团队规模(103 名开发者)以及使用该工具的项目多样性(10 个项目)也是促使我们选择他们的原因。为避免收集真实数据可能带来的风险或意外后果,我们未将任何结果与个别实践者关联,个体问卷结果也未与倍科方面的作者共享。数据分析针对采用 CodeReviewBot 的 10 个项目中的 3 个。这是因为这 3 个项目更早开始使用 CodeReviewBot(Project #1:2023 年 11 月 7 日;Project #2:2023 年 11 月 13 日;Project #3:2024 年 4 月 3 日)。其余 7 个项目约在 2024 年 6 月才采用 CodeReviewBot,因而尚未积累可观数据。表 I 给出这 3 个项目的信息。
III-B 研究目标与研究问题
本研究从多个视角考察自动化代码评审对软件开发的影响。在学术上,它提供实证数据以理解现代代码评审的未来方向,并揭示有前景的自动化代码评审工具的潜力。对实践者而言,关键在于自动化代码评审是否对开发过程产生正面影响。从业务角度看,实施此类工具涉及成本,必须由其收益来证明。从质量上看,自动化代码评审应增强而非削弱现有代码评审过程。因此,本研究对工业界专业人士与学者都是动机充分且有价值的调查。
我们通过从项目仓库与问卷收集数据来回答下列研究问题:
研究问题 1: 基于 LLM 的自动化代码评审在软件工业情境中有多大用处?
该问题评估基于 LLM 的自动化代码评审在软件开发中的效用。具体而言,我们想确定自动化代码评审工具生成的评论是否被有效纳入代码。这既取决于自动化评审是否有用,也取决于开发者对其的接受程度。
研究问题 2: 基于 LLM 的自动化代码评审如何影响 pull request 关闭过程的节奏?
自动化的主要动机之一是节省时间。通过该问题,我们考察基于 LLM 的自动化代码评审对开发节奏的影响。具体而言,我们想确定引入自动化代码评审是否会加快 pull request 关闭。通过分析这一影响,我们试图理解基于 LLM 的工具是否有助于更高效的开发工作流。
研究问题 3: 引入基于 LLM 的自动化代码评审如何影响人工代码评审活动的数量?
人工代码评审需要大量投入。引入基于 LLM 的自动化代码评审后,评估其对人工评审数量的影响至关重要。该问题旨在确定自动化工具会导致人工评审活动增加还是减少。我们希望理解自动化如何影响与人工代码评审相关的工作量。
研究问题 4: 开发者如何看待基于 LLM 的自动化代码评审工具?
开发者是代码评审过程中的重要参与者。他们对自动化代码评审工具的感知,对于实现预期收益至关重要。该问题旨在通过三角互证不同数据来源,分析开发者如何看待所收到的评论以及整个过程。这一综合评估将揭示开发者对自动化及其在代码评审中角色的态度。
为实现研究目标并回答问题,我们使用了定性与定量数据。实践者与自动化代码评审的交互是研究重点,因而需要定性数据。为此,我们设计了 pull request 问卷与总体意见问卷,并实施了强制评论解决策略,要求开发者标注评论如何被处理。定量数据方面,我们选择仓库挖掘,通过系统记录数字活动来洞察真实使用情况。我们通过分析历史 commit 数据、pull request 及相关评论,对问卷与评论解决标签的发现进行三角互证。图 4 给出数据收集概览。
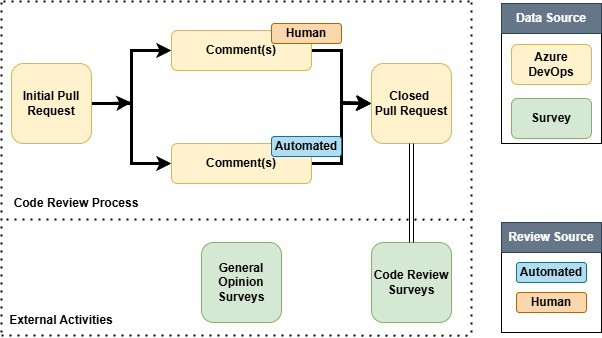
图 4: 数据收集概览
III-C 来自 Azure DevOps 的数据收集
我们从项目的版本控制系统(Azure DevOps)收集数据,包括 pull request 信息、评审评论,以及针对 pull request 的 commit。为更好地理解数据提取过程,我们描述图 4 中的组成部分。
1)初始 Pull Request: Pull request 是将变更引入代码库的机制。一旦创建 pull request,其他开发者会获知拟议变更。他们添加评审评论通知作者,作者应根据评审做必要修改。当代码达到可接受质量、变更合并入代码库后,pull request 被接受。
在我们的案例中,pull request 作者会同时收到自动评审评论与其他评审者的评论。本研究考虑 4,335 个 pull request,其中 1,568 个是在采用自动化代码评审之后创建的。
2)Pull Request 评论: Pull request 评论是代码评审过程的产物。人工评审者以评论形式添加评审。CodeReviewBot 则将其评审作为单独评论添加。我们从数量与时间、由谁生成,以及 pull request 作者如何从中受益等角度分析这些评论。
评论的存在并不意味着它被认真对待。为考察 pull request 作者是否从评审评论中受益,我们配置了强制评论解决策略 [43]。该机制要求作者标明如何处理 pull request 评论。遗憾的是,该策略是在 CodeReviewBot 之后才落地,因此我们没有策略实施前 pull request 的同类数据。表 II 给出每条评审评论的状态选项及其按评论解决策略的说明。
表 II: Azure DevOps 中的评论解决策略
| 状态 | 说明 |
|---|---|
| Active | 新评论的默认状态。 |
| Pending | 对应评论正在分析中,或在等待其他事项。 |
| Resolved | 对应评论成功,其建议已被落实。 |
| Won't fix | 对应评论有误,或无法落实。 |
| Closed | 对应评论因 “Won't Fix” 以外的其他原因未被落实。 |
3)已关闭的 Pull Request: 初始 pull request 中提出的代码变更可能随评审评论而改变。若评审指出了问题,这是预期事件。代码变更体现为额外 commit。Pull request 被接受或拒绝。倍科的实践者并不把拒绝当作质量保证机制,而是在变更被认为不必要或不合时宜时使用拒绝。因此,我们未将接受视为质量指标,而将其作为分类数据。
4)数据提取与分析: 数据分析从使用 API 从 Azure DevOps 服务器提取原始数据开始。我们建立了数据模式,以便在关系数据库中存储项目、仓库、commit、pull request 与 pull request 评论的信息,并用该模式存储 API 响应。
下一步是预处理数据以确保完整性与准确性。首先,我们将表转换为 CSV,使用 pandas 库^4 上传数据,并编写脚本提取相关指标。我们发现的第一个问题是 Active 评论数量很高,这本不应出现在评论解决策略之下。我们人工检查 pull request,观察到有些 pull request 在 CodeReviewBot 能够评论之前就已关闭。工具创建的评论在 pull request 关闭之后才到达,因而无需被解决。我们审视了合并 PR 所需时间,并用肘部法则确定了一个覆盖 93% PR 的阈值,然后将此过滤应用到全部历史以便公平评估。最后,我们人工剔除剩余 7%,以消除全部异常值。
第二个问题是部分开发者的评论数异常高。两名开发者的评论数不合理地高于其他人。我们检查其评论后发现,他们的 Azure DevOps 账号被用于不同的软件机器人,例如 SonarQube^5。我们也从研究中排除了这些账号。
最后,我们观察到许多评论因被删除、或包含 CodeReviewBot 生成的 pull request 描述而带有未知的评论解决标签。对此,我们排除了这类评论。此外,评论解决策略仅在 pull request 面向仓库主分支时生效,因此我们排除了面向主分支以外其他分支的 pull request。数据清洗过程包含非实践者作者与倍科参与者的多次协作会议,之后我们确认数据集没有损坏。最终,我们分析了 4,335 个 pull request,其中 1,568 个接受了自动化评审。
III-D 来自问卷的数据收集
1)代码评审问卷: 对每个 pull request,作者被要求为自动化评审评论打 0 到 5 分,并收到一份含三个问题的问卷。这些问卷是我们的第二数据源。前两个问题为 1 到 5 分量表,最后一个为开放题。代码评审问卷题目收录于复现包中。
2)总体意见问卷: 我们制作了总体意见问卷,并收到对本研究所涉三个项目有贡献的 22 名开发者的回复。这些实践者的从业年限与在组织中的职位各不相同。表 III 给出参与者信息。问卷聚焦自动化代码评审对开发者的影响及其看法。总体意见问卷题目亦收录于复现包中。
表 III: 问卷参与者
| 软件开发经验 | 参与人数 |
|---|---|
| 0–2 | 4 |
| 2–5 | 9 |
| 5–10 | 6 |
| 10+ | 3 |
| 在倍科的职位 | 参与人数 |
| 个人贡献者 | 16 |
| 主管/经理 | 6 |
| 实践者合计 | 22 |
III-E 研究问题的分析方法
由于研究问题具有多个方面,我们依赖多个数据源的发现。我们使用评审评论标签、评审之后针对 pull request 的 commit,以及总体意见问卷答案,为第一个研究问题建立多方面评估。我们从 Azure DevOps 提取 pull request 关闭时长以回答第二个研究问题。在总体意见问卷中,我们询问实践者自动化代码评审是否影响了开发节奏。
对第三个研究问题,我们从 Azure DevOps 提取人工代码评审数量,并在问卷中询问开发者是否能手动写出同样的评论。最后一个研究问题围绕开发者与 pull request 问卷。我们的数据分析脚本、问卷题目与结果已在复现包中共享^6。
IV 结果
IV-A 代码评审问卷
研究期间,我们收集了 38 个接受自动化代码评审的 pull request 的评分。Pull request 作者还被要求填写包含两道选择题与一道开放题的问卷,有 10 人完成。
自动化评审评论的平均评分为 3.46,标准差为 1.79。图 5 给出不同项目及总体评分。项目之间评分差异相当大:Project #1、#2、#3 的平均分分别为 4.04、2.72 和 3.00。这可能表明不同项目条件下评审质量存在差异,也可能源于不同项目开发者之间的差异。
我们发给作者的问卷包含三个问题。前两个问题分别关于作者是否认同这些评审,以及他们认为评审评论的呈现如何。第三个问题为开放题,征求额外反馈。
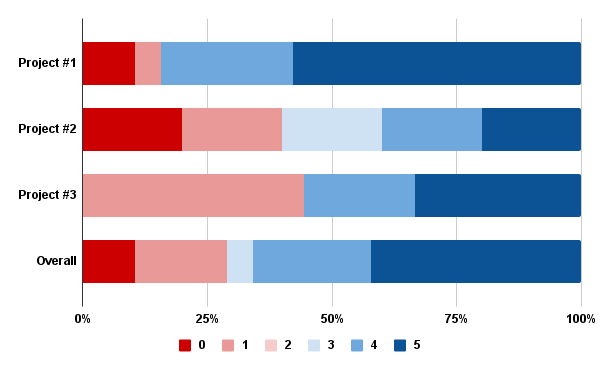
图 5: 代码评审问卷中的自动化代码评审评分
遗憾的是,第三个问题收到的回答不多。多数回答是 “Great.” 一类简短评语。10 名实践者回答了前两个问题,我们在图 6 中报告。当被问及评论有多「可认同」时,8 人答 “5”;当被问及评论呈现得有多好时,9 人答 “5”。有 1 人对两个问题都答 “1”。评分数量与问卷回复数量存在差异。由于问卷需要额外投入,不满意的开发者可能更缺乏动力去完成问卷。总体而言,评分与 pull request 问卷表明开发者认为评论可认同且呈现良好。
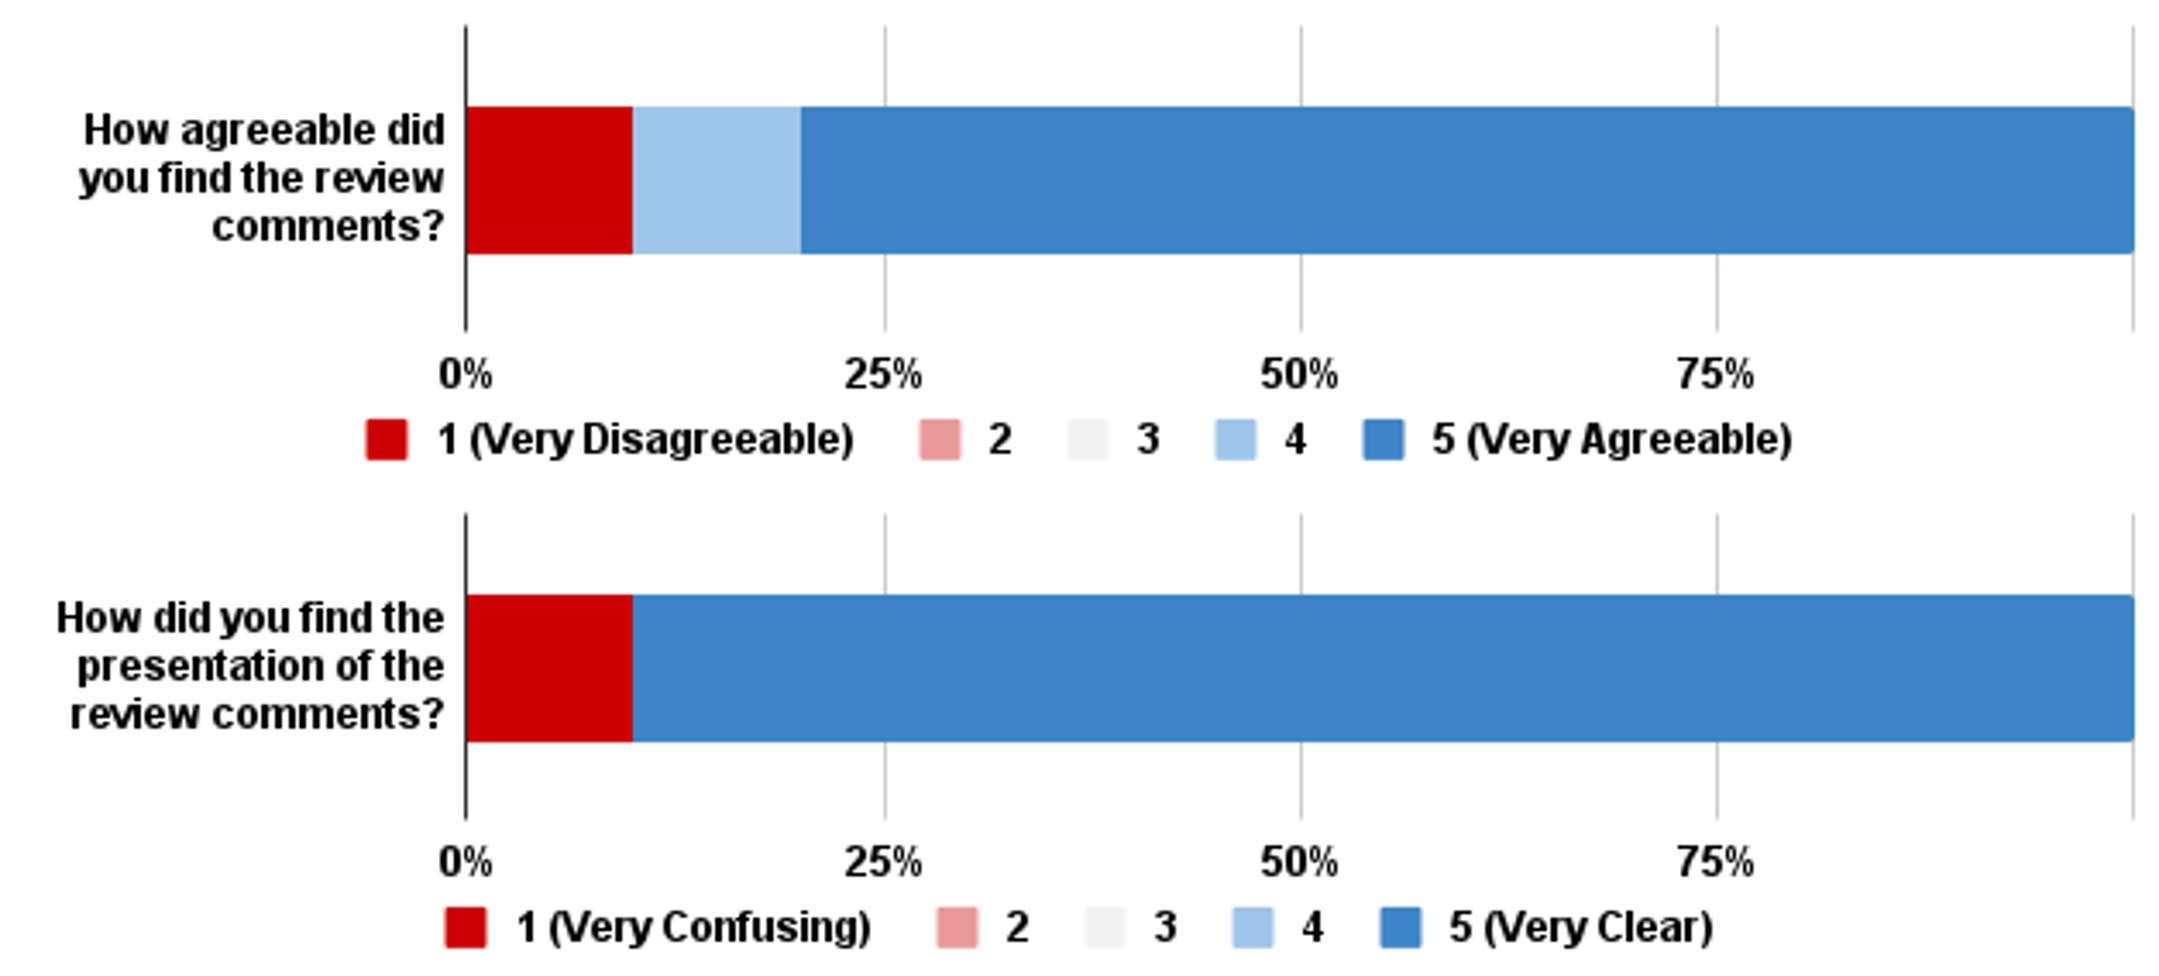
图 6: 代码评审问卷
IV-B 总体意见问卷
我们向参与这些项目的开发者发送了含 8 个问题的问卷。收到 23 份回复,其中 22 名受访者同意将其纳入发表结果。该问卷旨在收集开发者的总体看法。
问卷包含 6 道选择题与 2 道开放题。图 7 与图 8 给出结果。第一个问题针对自动化代码评审对开发速度的影响。8 名开发者认为自动化代码评审使开发节奏有轻微改善,4 人认为没有影响,3 人认为有轻微恶化,2 人认为有重大改善。
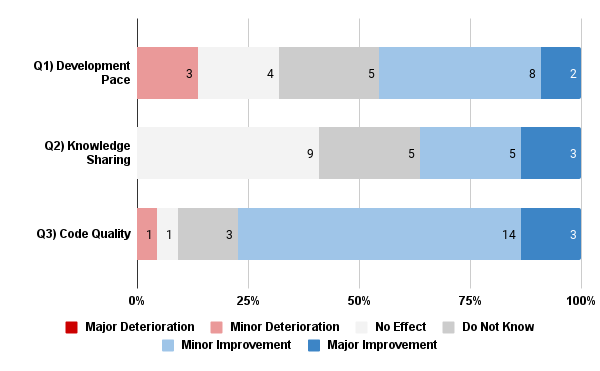
图 7: 总体意见问卷回复(问题 1–3)
第二个问题聚焦知识共享。9 名实践者认为对开发者之间的知识共享没有影响,同时有 8 名开发者认为有正面影响。第三个问题探讨代码质量,多数受访者(14 人)认为自动化代码评审对整体代码质量有轻微改善。
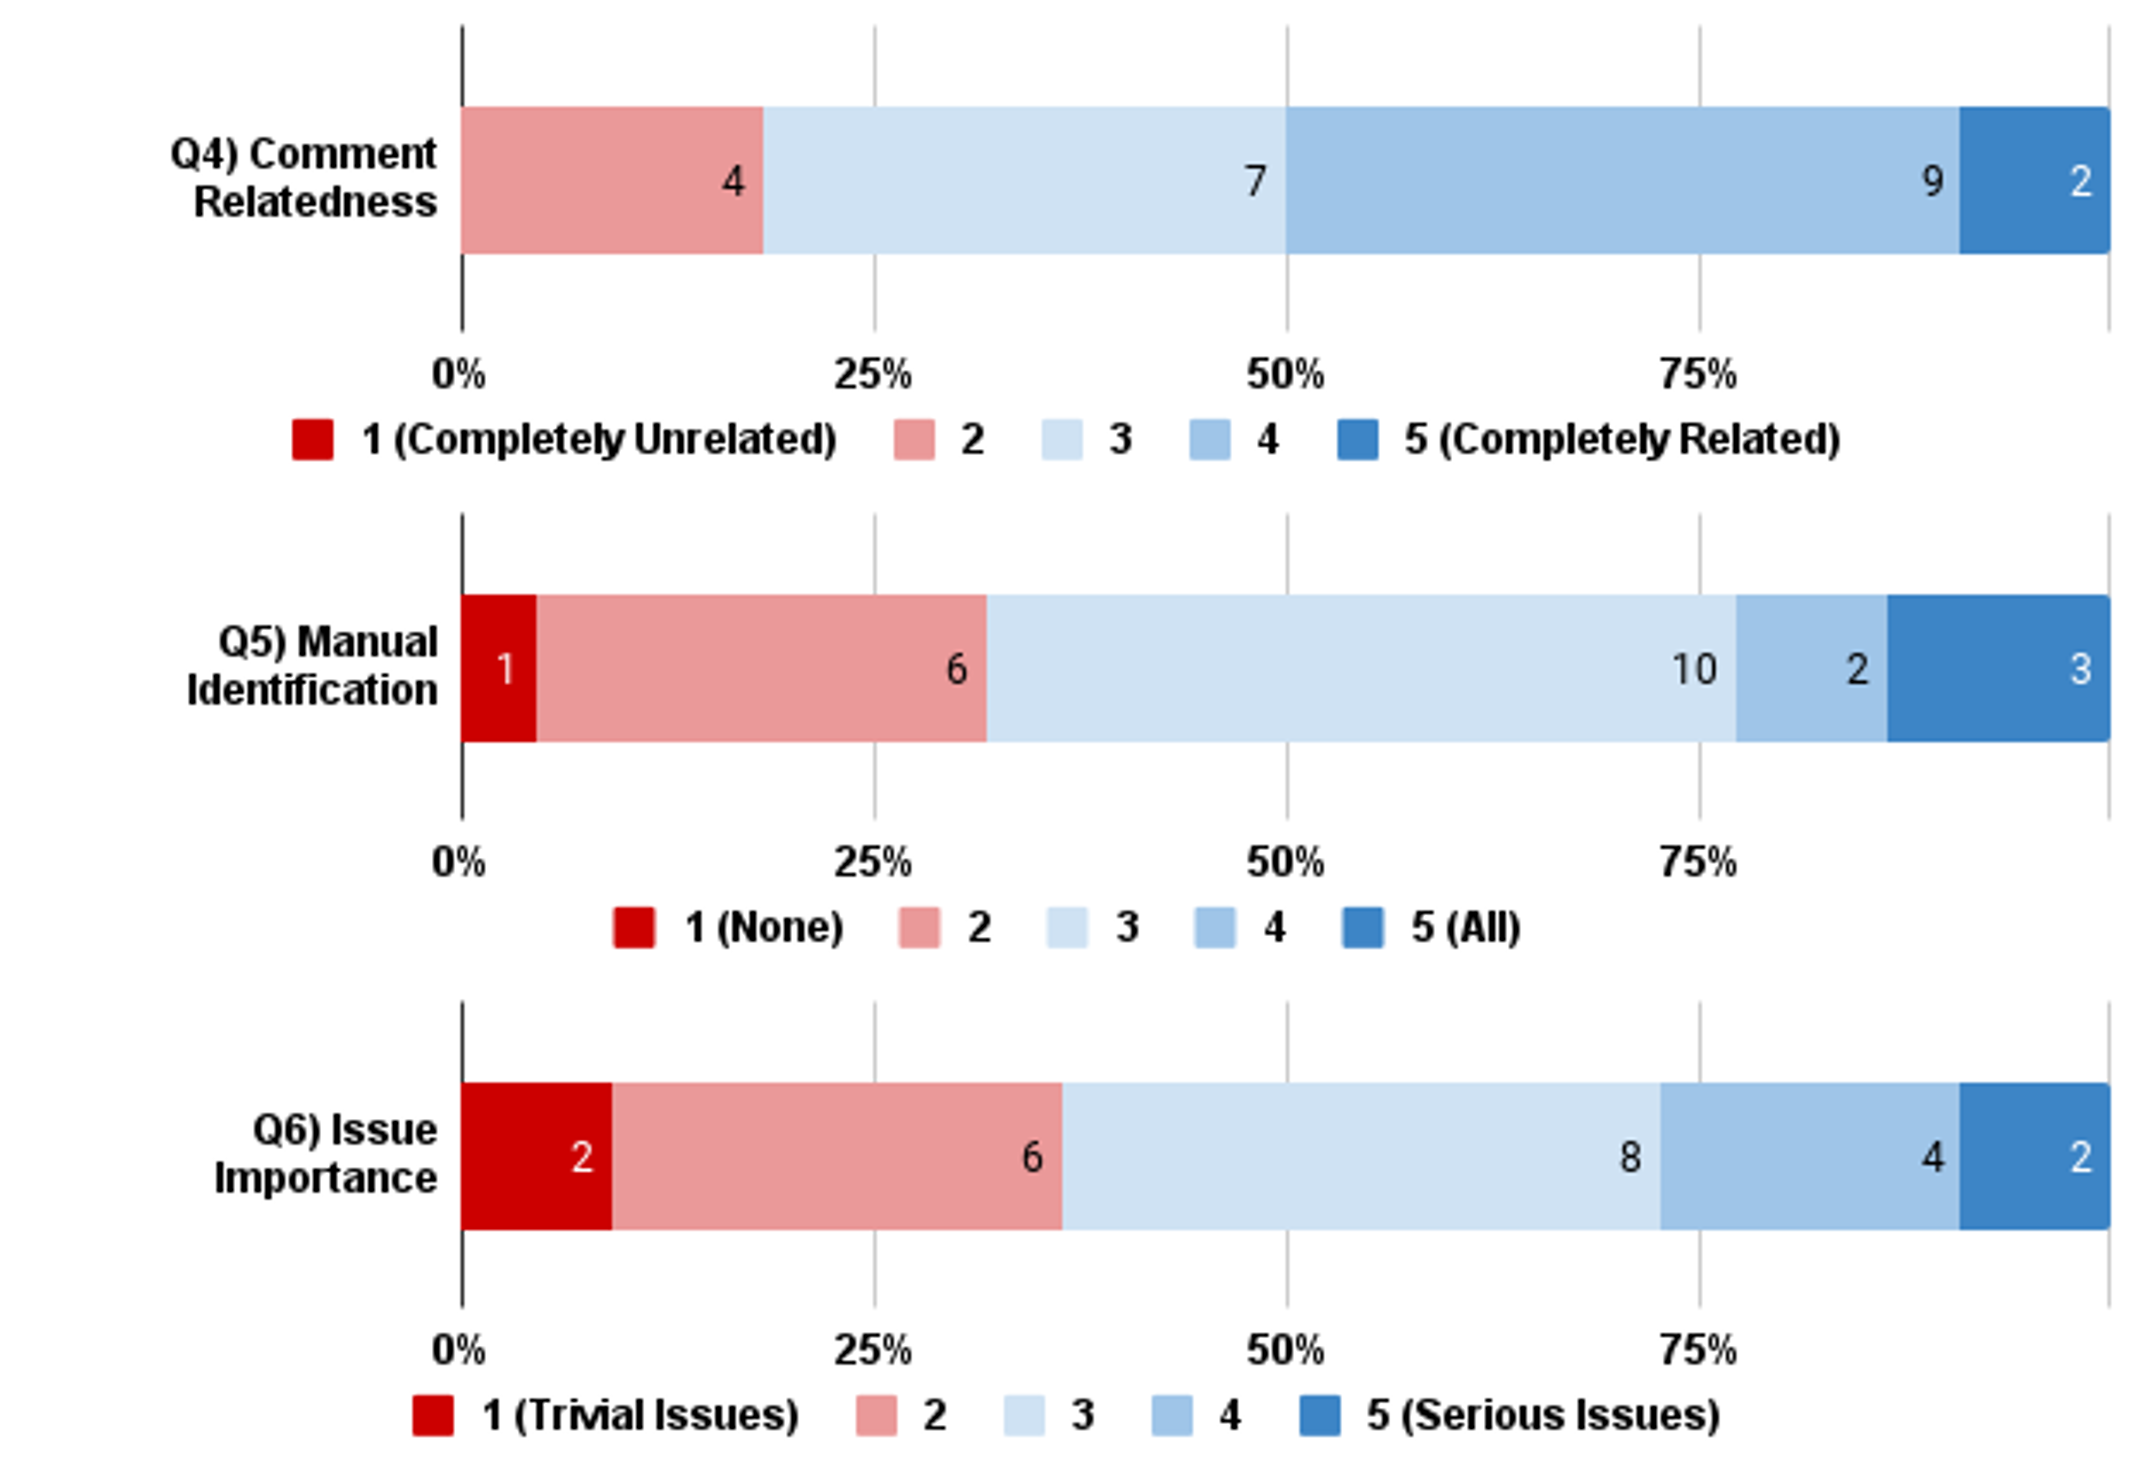
图 8: 总体意见问卷回复(问题 4–6)
第四个问题考察自动化代码评审生成的评论与 pull request 的相关程度。9 名受访者将相关度评为 “4”,7 人评为 “3”,表明多数实践者认为自动化评论与 pull request 相关。
第五个问题询问开发者能否手动识别自动化代码评审所指出的问题:“1” 表示完全无法手动识别,“5” 表示能够识别全部。10 名受访者评 “3”,6 人评 “2”。
第六个问题针对自动化评审所强调问题的重要性。8 人评 “3”,6 人评 “2”。评分的分散表明实践者看法不一。
IV-C Azure DevOps 数据分析
IV-C 1 评论标签
分析中我们提取了 CodeReviewBot 的 4,408 条评论。由于评论解决策略是在 CodeReviewBot 之后才强制执行,我们过滤了策略引入之前的评论以及当前仍为 Active 或 Pending 的评论。过滤后,我们考察了已合并 pull request 上的 1,408 条 CodeReviewBot 评论。各项目的评论状态见图 9。73.8% 的评论被标记为 “Resolved”,21.3% 被标记为 “Won't Fix”。跨项目比较时,Project #1 与 Project #3 差异显著,分别有 55% 与 90% 的评论被标记为 “Resolved”。
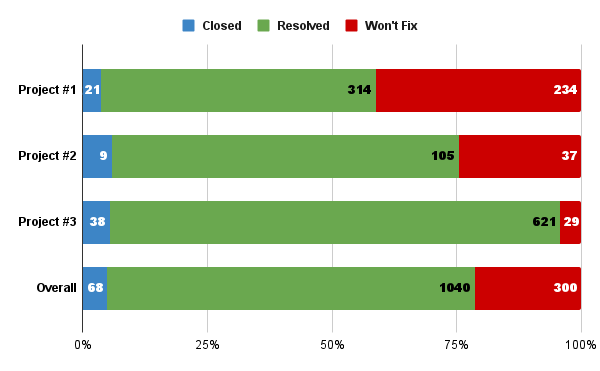
图 9: 已合并 PR 上的评论标签
RQ1:基于 LLM 的自动化代码评审在软件工业情境中有多大用处?
我们的分析显示,开发者接受并落实了 CodeReviewBot 所建议评论中的 73.8%,凸显了该机器人对代码评审过程的显著影响。此外,在人工评审者评论之前,有 88 次 commit 是在 CodeReviewBot 之后做出的,表明存在基于机器人建议的主动变更。多数问卷受访者也认为使用 CodeReviewBot 后代码质量有所改善。因此,我们得出结论:在该公司情境中,基于 LLM 的自动化代码评审非常有用。
IV-C 2 Pull Request 上的 Commit
作为代码评审过程所引起变更的度量,pull request 在收到评论后会获得 commit。我们分析了 CodeReviewBot 落地之后这些 pull request 上的 commit,结果见图 10。在 CodeReviewBot 评论之后、人工评论之前,pull request 收到 88 次 commit。人工评审者评论之后,pull request 收到 69 次 commit。需要指出,作者也可能在人工评审者评论之后才根据 CodeReviewBot 的评论采取行动。反之,有些 pull request 可能以草稿打开,随后再追加新 commit。CodeReviewBot 之后的 commit 数量与带 “Resolved” 标签的评论数量之间存在差异是预期的。由于 pull request 会收到不止一条评论,而 commit 是针对整个 pull request 做出的,“Resolved” 标签的评论应多于 commit。然而,开发者也可能无视预期的标签策略,用 “Resolved” 代替 “Closed” 或 “Won't Fix”。“Closed” 指评论本身并非错误,但因其他原因未被落实。
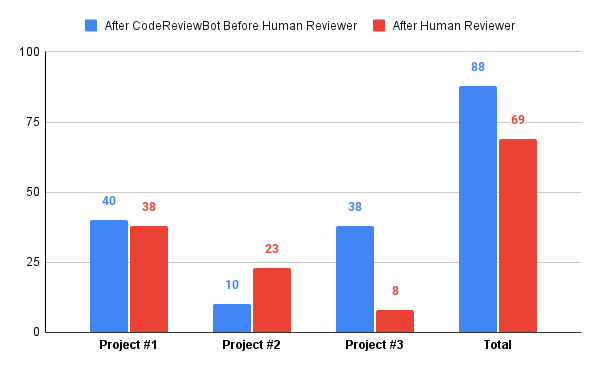
图 10: 代码评审之后的 Commit
IV-C 3 Pull Request 关闭时长
总体平均 pull request 关闭时长在引入 CodeReviewBot 之前为 5 小时 52 分钟,之后增加到 8 小时 20 分钟。独立样本 t 检验表明这一总体增加具有统计显著性(p-value $<<$ 0.001)。如图 11 所示,不同项目呈现不同趋势。
Project #1 的关闭时长显著增加,从 2 小时 48 分钟升至 4 小时 38 分钟。t 检验表明该增加具有统计显著性(p-value $<<$ 0.001)。Project #2 的关闭时长显著下降,从 6 小时 6 分钟降至 3 小时 7 分钟,结果具有统计显著性(p-value $<<$ 0.001)。Project #3 的关闭时长从 20 小时 22 分钟增至 30 小时 51 分钟,统计检验表明该增加具有统计显著性(p-value $<<$ 0.001)。
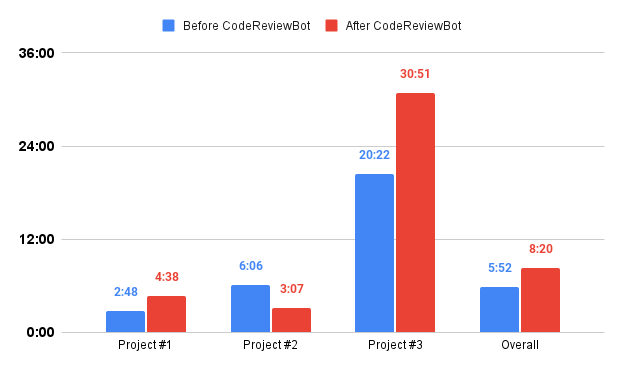
图 11: 引入 CodeReviewBot 前后的 Pull Request 关闭时长(H:MM)
RQ2:基于 LLM 的自动化代码评审如何影响 pull request 关闭过程的节奏?
结果表明 pull request 关闭过程显著变慢。这一变慢可以解释为:开发者需要处理来自机器人以及人工评审者的额外评论。关闭时长的影响在不同项目间存在差异,表明项目特定条件在决定效果时起关键作用。
IV-C 4 人工评审者评论
总体而言,部署 CodeReviewBot 之前,人工评审者平均每个 pull request 留下 0.31 条评论,之后降至 0.28,如图 12 所示。Poisson 回归分析表明这一总体下降不具有统计显著性(p-value $\geq$ 0.05)。作为对比,CodeReviewBot 平均每个 pull request 留下 3.65 条评论。统计分析揭示了不同项目的不同趋势:
引入 CodeReviewBot 后,Project #1 每个 pull request 的人工评论显著增加(从 0.14 到 0.29,p-value $<<$ 0.05),Project #2 显著下降(从 0.37 到 0.08,p-value $<<$ 0.05),Project #3 在统计上保持不变(从 0.50 到 0.49,p-value $\geq$ 0.05)。
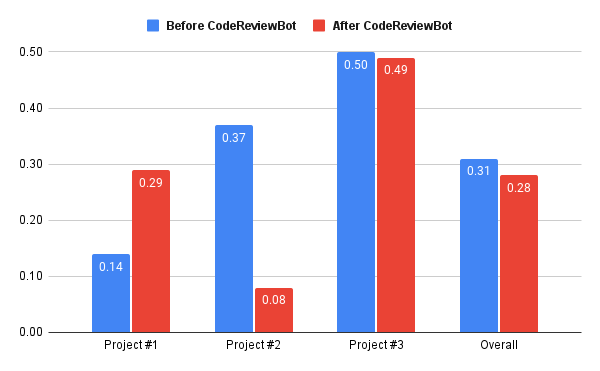
图 12: 人工评审者评论的平均数量
RQ3:引入基于 LLM 的自动化代码评审如何影响人工代码评审活动的数量?
引入 CodeReviewBot 后,人工评论的平均数量从 0.31 降至 0.28。然而,根据 Poisson 回归分析,该下降不具有统计显著性。此外,基于 LLM 的自动化代码评审对人工评审活动的影响因项目而异,可能受到项目动态与团队实践的影响。
IV-D 总体意见问卷开放题
总体意见问卷有两个关于自动化代码评审优缺点的问题。我们收到 20 份有效回答,另有 2 份无用回复(空白)。相当比例的参与者(13/20)提到代码质量改进与编码标准维护方面的优点。部分受访者强调评审过程的改善,例如缩短评审过程、帮助发现被忽略的 code smell 与潜在缺陷。自动生成的代码描述被认为有助于加快评审。其他显著优点包括提供改进建议、增强对最佳实践的意识。
RQ4:开发者如何看待基于 LLM 的自动化代码评审工具?
部分实践者担心超出范围或不相关的建议会拖慢评审并造成干扰。也有实践者担心自动化代码评审会漏掉人工评审者能够发现的关键问题。一名受访者提出重要担忧:自动化代码评审可能改变 pull request 的上下文,如果未经审慎考虑就应用变更,可能引入严重缺陷。尽管存在这些弊端,多数开发者仍认为自动化代码评审工具有益于提升代码质量与维护编码标准,尤其是在检测质量问题并提供改进建议方面。
V 讨论
V-A 基于 LLM 的自动化代码评审是否显著改善了软件开发活动?
实施基于 LLM 的自动化代码评审工具是重大的组织决策,既有收益也有成本。此类工具会产生费用——例如在本研究中,CodeReviewBot 平均每个 pull request 使用 3,937 个 token,成本为 0.48 美元——同时也要求开发者投入时间处理评审评论。
Pull request 作者所赋的评论标签显示,73.8% 的评论被作者处理。此外,我们观察到在人工评审之前,CodeReviewBot 的评审之后有 88 次 commit,表明自动化评审影响了 pull request。对开发者的问卷显示,68.8% 认为引入 CodeReviewBot 后代码质量有轻微改善。根据问卷结果,实践者认为 CodeReviewBot 指出的问题重要且与相应 pull request 相关。这进一步支持了基于 LLM 的自动化代码评审的有用性。
除对代码质量有用外,代码评审也有助于知识共享 [5]。在总体意见问卷中,我们询问实践者 CodeReviewBot 是否影响了知识共享。多数受访者称没有影响,没有受访者指出负面影响。
自动化代码评审常被提及的收益之一是节省时间与开发者投入 [31]。为此,我们分析了 pull request 关闭时长。尽管我们观察到关闭时间总体增加,这可能归因于作者花额外时间修复自动化评审机器人指出的问题。不同项目趋势差异显著,表明开发者在积极回应自动化反馈,这可能延长了关闭时间,但潜在带来更高的代码质量。此外,分析显示引入自动化工具后,每个 pull request 的人工评审评论数量并未显著下降。这表明尽管开发者投入额外精力处理自动化评论,它并未取代人工评审的需求。因此,我们并未发现实施自动化代码评审工具能持续节省时间或投入的结论性证据。
我们的发现表明,自动化代码评审可以适度改善软件开发活动。是否实施此类工具仍应审慎考虑。本研究中观察到的收益,可能受既有代码评审习惯或其他已有质量保证活动的制约。
V-B 对实践者的启示
对自动化代码评审的过度依赖: 总体意见问卷中一名受访者说:“It may create bias so reviewers may ignore by saying that if any other issue exists, the bot would have written it.”(它可能造成偏见,评审者会想:如果还有别的问题,机器人早就写出来了。)这种对自动化的过度依赖可能有害于组织,使严重缺陷被忽略。实践者应在大规模采用之前,充分考察基于 LLM 的自动化代码评审工具。应建立对其局限的组织认知,并采取必要防范。
不必要的评审评论: 评论解决标签显示,26.2% 的工具评论未被落实,被标为 “Won't Fix” 或 “Closed”。这些评论可能过于琐碎、不相关,或在该 pull request 的情境中并不构成问题。无论哪种情况,开发者都要花时间处理。问卷受访者也提到这一问题。一名受访者说:“It also makes suggestions that fix code blocks that are not in the scope of the task.”(它还会建议修改不在任务范围内的代码块。)另一名说:“Sometimes the mistakes it thinks it finds are not mistakes at all.”(有时它自以为发现的错误根本不是错误。)
尽早发现缺陷: 问卷显示尽早发现缺陷是自动化代码评审的优点。一名受访者说:“It makes finding code defects more easy. Developers can see their mistakes fast.”(它让发现代码缺陷更容易。开发者能更快看到自己的错误。)受访者也强调该工具检测拼写错误与遗留测试代码的能力。另一人说:“very effective in detecting overlooked code smells”(在发现被忽略的 code smell 方面非常有效)。这些评论说明该工具如何能够改善代码质量。
V-C 对研究者的启示
基于 LLM 的工具的有效性: 本研究为基于 LLM 的自动化代码评审工具在真实工业环境中的有效性提供了有价值的实证证据。开发者的正面接受度,以及 pull request 中被落实的评论比例(73.8%),表明 LLM 能够增强代码评审过程。一名受访者说:“It improved the awareness of the team about code quality.”(它提高了团队对代码质量的意识。)这一评论表明该工具的影响超出了代码评审实践本身。
人机交互动态: 将自动化评审纳入代码评审过程,引入了新的人机交互动态。发现之一是递归评审造成的挫败感,一名受访者说:“With each fix, a new review is generated. However, after the initial review, subsequent comments on revised pull requests often become redundant and unhelpful.”(每次修复都会生成新的评审。然而,在初次评审之后,针对修订后 pull request 的后续评论往往变得冗余且无帮助。)研究者可以考察影响开发者信任、满意度以及对自动化评审依赖程度的因素,从而推动这些工具更以人为中心的设计改进。
VI 效度威胁
VI-A 构念效度
我们的数据收集包括通过问卷答案与评论解决标签从受访者处收集数据。这些条目可能被误解。为缓解这一效度威胁,我们投入额外精力向受访者解释期望。我们还与多名评审者彻底审阅题目,改写可能令人困惑或复杂的表述。
VI-B 内部效度
本文部分作者属于倍科软件开发组织。具体而言,其中一位作者在该组织担任管理职位。这引入了偏见的可能。为保持中立,本文的结果与讨论由非实践者作者完成。
我们承认,强制评论解决策略可能被实践者视为耗时,因为他们未必提供可靠的评论解决标签。为应对这一威胁,我们通过三角互证数据来源得出结论。例如,我们将评论标签与 pull request 变更信息对照,看二者在何种程度上一致。
我们的数据收集集中在夏季。倍科实践者提到夏季有更多开发者休假,会降低生产率与开发节奏。因此,我们承认结论受季节性影响。
本研究所考察的项目是研究开始前早已启动的真实项目。为避免意外影响与伦理问题,我们未将任何结果与个别实践者关联。因此,项目中的实践者没有动机表现得与平时不同,因为分析是事后独立进行的。
由于 pull request 作者反复填写同一份 pull request 问卷,我们考虑他们可能感到烦躁并随意作答。为避免参与度下降,我们将问卷限制为三个问题。
定量数据分析依赖于 Azure DevOps 中数据的完整性。数据库损坏可能影响结果。为缓解此类损坏,我们开展了联合数据清洗会议,讨论数据质量。我们识别出项目中有两个账号曾在一段时间内被用作机器人账号,并移除了这些账号的评论。我们承认这些评论中可能包含人工评论,尽管其中大多数来自机器人。
尽管 “Active” 与 “Pending” 评论本不应允许 pull request 关闭,我们观察到部分自动化评论在 pull request 关闭之后才到达。这些评论大多保持 Active,我们在分析中将其忽略。
VI-C 外部效度
本研究使用特定的自动化代码评审工具(Qodo PR Agent [29])与特定 LLM(GPT-4 32k [30])。由于使用了这一特定工具与模型,我们承认其他 LLM 与自动化代码评审工具可能表现不同。因此,需要进一步研究以确定其他 LLM 是否会有类似行为。
VI-D 结论效度
在不同公司情境中,本研究可能得到不同结果。我们无法控制众多变化条件以得出统计结论,因此认为案例研究是最合适的方法。要得出确定性结论,需要用我们的方法做多案例研究。鉴于开展如此全面研究的挑战,我们限制了范围,并不追求统计上的泛化。
VII 结论
本研究在跨国企业倍科的软件开发部门开展评估性案例研究,聚焦自动化代码评审。基于开源 Qodo PR-Agent [29] 的 LLM 自动化代码评审工具被用于 10 个项目。我们将研究范围收窄到其中 3 个使用该工具时间更长的项目。
发现表明该工具有效,73.8% 的评论得到落实。此外,多数开发者在问卷中报告代码质量有轻微改善,且知识共享没有恶化。关于 pull request 关闭时间,引入工具前后的平均时长从 5 小时 52 分钟增加到 8 小时 20 分钟,且具有统计显著性。不同项目趋势不一,其中一个项目的 pull request 关闭时长下降。此外,引入工具前后人工代码评审数量没有显著变化。
由于开发者是与工具交互的主要用户,我们考察了他们对自动化代码评审的感知。问卷显示,实践者普遍认为自动化评审所识别的问题重要且与 pull request 相关。参与者提到若干有助于代码质量的优点,包括更快发现缺陷、消除 code smell、提高代码质量意识,以及推广标准化最佳实践。缺点包括对超出范围代码变更的建议,以及偶尔错位的推荐,会分散开发者注意力并拖慢开发。也有人对过度依赖自动化系统的弊端表示担忧。
研究表明自动化代码评审可以对软件开发产生正面影响;然而,也识别出一些意外效果与缺点。实践者可利用这些见解,就基于 LLM 的自动化代码评审工具的实施与使用做出更知情的决策。未来我们计划在不同软件开发公司复现本研究,以考虑组织间差异。
VIII 致谢
本工作得到 ITEA4 GENIUS 项目支持,该项目由参与国家的国家资助机构资助:https://itea4.org/project/genius.html
参考文献
[1] T. Baum, O. Liskin, K. Niklas, and K. Schneider, “A faceted classification scheme for change-based industrial code review processes,” in 2016 IEEE International Conference on Software Quality, Reliability and Security (QRS), 2016, pp. 74–85.
[2] M. E. Fagan, “Design and code inspections to reduce errors in program development,” IBM Systems Journal, vol. 15, no. 3, pp. 182–211, 1976.
[3] N. Davila and I. Nunes, “A systematic literature review and taxonomy of modern code review,” Journal of Systems and Software, vol. 177, p. 110951, 2021. [Online]. Available: https://www.sciencedirect.com/science/article/pii/S0164121221000480
[4] A. Bacchelli and C. Bird, “Expectations, outcomes, and challenges of modern code review,” in 2013 35th International Conference on Software Engineering (ICSE), 2013, pp. 712–721.
[5] L. MacLeod, M. Greiler, M.-A. Storey, C. Bird, and J. Czerwonka, “Code reviewing in the trenches: Challenges and best practices,” IEEE Software, vol. 35, no. 4, pp. 34–42, 2018.
[6] C. Sadowski, E. Söderberg, L. Church, M. Sipko, and A. Bacchelli, “Modern code review: A case study at google,” in International Conference on Software Engineering, Software Engineering in Practice track (ICSE SEIP), 2018.
[7] A. Bosu and J. C. Carver, “Impact of peer code review on peer impression formation: A survey,” in 2013 ACM / IEEE International Symposium on Empirical Software Engineering and Measurement, 2013, pp. 133–142.
[8] P. C. Rigby and C. Bird, “Convergent contemporary software peer review practices,” in Proceedings of the 2013 9th Joint Meeting on Foundations of Software Engineering, ser. ESEC/FSE 2013. New York, NY, USA: Association for Computing Machinery, 2013, p. 202–212. [Online]. Available: https://doi.org/10.1145/2491411.2491444
[9] Y. Hong, C. Tantithamthavorn, P. Thongtanunam, and A. Aleti, “Commentfinder: a simpler, faster, more accurate code review comments recommendation,” in Proceedings of the 30th ACM Joint European Software Engineering Conference and Symposium on the Foundations of Software Engineering, ser. ESEC/FSE 2022. New York, NY, USA: Association for Computing Machinery, 2022, p. 507–519. [Online]. Available: https://doi.org/10.1145/3540250.3549119
[10] Z. Li, S. Lu, D. Guo, N. Duan, S. Jannu, G. Jenks, D. Majumder, J. Green, A. Svyatkovskiy, S. Fu, and N. Sundaresan, “Automating code review activities by large-scale pre-training,” 2022.
[11] R. Tufano, S. Masiero, A. Mastropaolo, L. Pascarella, D. Poshyvanyk, and G. Bavota, “Using pre-trained models to boost code review automation,” CoRR, vol. abs/2201.06850, 2022. [Online]. Available: https://arxiv.org/abs/2201.06850
[12] L. Li, L. Yang, H. Jiang, J. Yan, T. Luo, Z. Hua, G. Liang, and C. Zuo, “Auger: Automatically generating review comments with pre-training models,” 2022.
[13] J. Yu, P. Liang, Y. Fu, A. Tahir, M. Shahin, C. Wang, and Y. Cai, “Security code review by large language models,” 2024. [Online]. Available: https://arxiv.org/abs/2401.16310
[14] L. Fan, J. Liu, Z. Liu, D. Lo, X. Xia, and S. Li, “Exploring the capabilities of llms for code change related tasks,” 2024. [Online]. Available: https://arxiv.org/abs/2407.02824
[15] M. Vijayvergiya, M. Salawa, I. Budiselić, D. Zheng, P. Lamblin, M. Ivanković, J. Carin, M. Lewko, J. Andonov, G. Petrović et al., “Ai-assisted assessment of coding practices in modern code review,” in Proceedings of the 1st ACM International Conference on AI-Powered Software, 2024, pp. 85–93.
[16] C. Pornprasit and C. Tantithamthavorn, “Fine-tuning and prompt engineering for large language models-based code review automation,” Information and Software Technology, vol. 175, p. 107523, 2024. [Online]. Available: https://www.sciencedirect.com/science/article/pii/S0950584924001289
[17] M. Nashaat and J. Miller, “Towards efficient fine-tuning of language models with organizational data for automated software review,” IEEE Transactions on Software Engineering, pp. 1–14, 2024.
[18] D. Tang, K. Kim, Y. Song, C. Lothritz, B. Li, S. Ezzini, H. Tian, J. Klein, and T. F. Bissyandé, “Codeagent: Collaborative agents for software engineering,” 2024. [Online]. Available: https://api.semanticscholar.org/CorpusID:267412469
[19] Z. Rasheed, M. A. Sami, M. Waseem, K.-K. Kemell, X. Wang, A. Nguyen, K. Systä, and P. Abrahamsson, “Ai-powered code review with llms: Early results,” 2024.
[20] R. Tufano, O. Dabić, A. Mastropaolo, M. Ciniselli, and G. Bavota, “Code review automation: Strengths and weaknesses of the state of the art,” IEEE Trans. Softw. Eng., vol. 50, no. 2, p. 338–353, Jan. 2024. [Online]. Available: https://doi.org/10.1109/TSE.2023.3348172
[21] S.-T. Shi, M. Li, D. Lo, F. Thung, and X. Huo, “Automatic code review by learning the revision of source code,” Proceedings of the AAAI Conference on Artificial Intelligence, vol. 33, no. 01, pp. 4910–4917, Jul. 2019. [Online]. Available: https://ojs.aaai.org/index.php/AAAI/article/view/4420
[22] H.-Y. Li, S.-T. Shi, F. Thung, X. Huo, B. Xu, M. Li, and D. Lo, “Deepreview: Automatic code review using deep multi-instance learning,” in Advances in Knowledge Discovery and Data Mining: 23rd Pacific-Asia Conference, PAKDD 2019, Macau, China, April 14-17, 2019, Proceedings, Part II. Berlin, Heidelberg: Springer-Verlag, 2019, pp. 318–330. [Online]. Available: https://doi.org/10.1007/978-3-030-16145-3_25
[23] M. Tufano, J. Pantiuchina, C. Watson, G. Bavota, and D. Poshyvanyk, “On learning meaningful code changes via neural machine translation,” CoRR, vol. abs/1901.09102, 2019. [Online]. Available: http://arxiv.org/abs/1901.09102
[24] P. Thongtanunam, C. Pornprasit, and C. Tantithamthavorn, “Autotransform: Automated code transformation to support modern code review process,” in Proceedings of the 44th international conference on software engineering, 2022, pp. 237–248.
[25] A. Gupta and N. Sundaresan, “Intelligent code reviews using deep learning,” in Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD’18) Deep Learning Day, 2018.
[26] OpenAI, “Chatgpt,” https://www.openai.com/chatgpt, 2023, accessed: 2024-04-28.
[27] N. Davila, J. Melegati, and I. Wiese, “Tales from the trenches: Expectations and challenges from practice for code review in the generative ai era,” IEEE Software, vol. PP, pp. 1–8, 01 2024.
[28] “What is coderabbit?” May 2023. [Online]. Available: https://docs.coderabbit.ai/
[29] “Codium-ai/pr-agent,” September 2024. [Online]. Available: https://github.com/Codium-ai/pr-agent
[30] J. Achiam, S. Adler, S. Agarwal, L. Ahmad, I. Akkaya, F. L. Aleman, D. Almeida, J. Altenschmidt, S. Altman, S. Anadkat et al., “Gpt-4 technical report,” arXiv preprint arXiv:2303.08774, 2023.
[31] R. Tufano, L. Pascarella, M. Tufano, D. Poshyvanyk, and G. Bavota, “Towards automating code review activities,” in Proceedings of the 43rd International Conference on Software Engineering, ser. ICSE ’21. IEEE Press, 2021, p. 163–174. [Online]. Available: https://doi.org/10.1109/ICSE43902.2021.00027
[32] W. H. A. Al-Zubaidi, P. Thongtanunam, H. K. Dam, C. Tantithamthavorn, and A. Ghose, “Workload-aware reviewer recommendation using a multi-objective search-based approach,” in Proceedings of the 16th ACM International Conference on Predictive Models and Data Analytics in Software Engineering, ser. PROMISE 2020. New York, NY, USA: Association for Computing Machinery, 2020, p. 21–30. [Online]. Available: https://doi.org/10.1145/3416508.3417115
[33] S. Asthana, R. Kumar, R. Bhagwan, C. Bird, C. Bansal, C. Maddila, S. Mehta, and B. Ashok, “Whodo: automating reviewer suggestions at scale,” in Proceedings of the 2019 27th ACM Joint Meeting on European Software Engineering Conference and Symposium on the Foundations of Software Engineering, ser. ESEC/FSE 2019. New York, NY, USA: Association for Computing Machinery, 2019, p. 937–945. [Online]. Available: https://doi.org/10.1145/3338906.3340449
[34] J. Jiang, D. Lo, J. Zheng, X. Xia, Y. Yang, and L. Zhang, “Who should make decision on this pull request? analyzing time-decaying relationships and file similarities for integrator prediction,” Journal of Systems and Software, vol. 154, pp. 196–210, 2019. [Online]. Available: https://www.sciencedirect.com/science/article/pii/S0164121219300962
[35] H. Ying, L. Chen, T. Liang, and J. Wu, “Earec: Leveraging expertise and authority for pull-request reviewer recommendation in github,” in 2016 IEEE/ACM 3rd International Workshop on CrowdSourcing in Software Engineering (CSI-SE), 2016, pp. 29–35.
[36] E. Mirsaeedi and P. C. Rigby, “Mitigating turnover with code review recommendation: balancing expertise, workload, and knowledge distribution,” in Proceedings of the ACM/IEEE 42nd International Conference on Software Engineering, ser. ICSE ’20. New York, NY, USA: Association for Computing Machinery, 2020, p. 1183–1195. [Online]. Available: https://doi.org/10.1145/3377811.3380335
[37] A. Ouni, R. G. Kula, and K. Inoue, “Search-based peer reviewers recommendation in modern code review,” in 2016 IEEE International Conference on Software Maintenance and Evolution (ICSME), 2016, pp. 367–377.
[38] M. M. Rahman, C. K. Roy, and J. A. Collins, “Correct: Code reviewer recommendation in github based on cross-project and technology experience,” in 2016 IEEE/ACM 38th International Conference on Software Engineering Companion (ICSE-C), 2016, pp. 222–231.
[39] P. Thongtanunam, C. Tantithamthavorn, R. G. Kula, N. Yoshida, H. Iida, and K.-i. Matsumoto, “Who should review my code? a file location-based code-reviewer recommendation approach for modern code review,” in 2015 IEEE 22nd International Conference on Software Analysis, Evolution, and Reengineering (SANER), 2015, pp. 141–150.
[40] E. Sülün, E. Tüzün, and U. Doğrusöz, “Rstrace+: Reviewer suggestion using software artifact traceability graphs,” Information and Software Technology, vol. 130, p. 106455, 2021. [Online]. Available: https://www.sciencedirect.com/science/article/pii/S0950584920300021
[41] C. Raffel, N. Shazeer, A. Roberts, K. Lee, S. Narang, M. Matena, Y. Zhou, W. Li, and P. J. Liu, “Exploring the limits of transfer learning with a unified text-to-text transformer,” CoRR, vol. abs/1910.10683, 2019. [Online]. Available: http://arxiv.org/abs/1910.10683
[42] M. Watanabe, Y. Kashiwa, B. Lin, T. Hirao, K. Yamaguchi, and H. Iida, “On the use of chatgpt for code review: Do developers like reviews by chatgpt?” in Proceedings of the 28th International Conference on Evaluation and Assessment in Software Engineering, ser. EASE ’24. New York, NY, USA: Association for Computing Machinery, 2024, p. 375–380. [Online]. Available: https://doi.org/10.1145/3661167.3661183
[43] “Branch policies and settings,” May 2024. [Online]. Available: https://learn.microsoft.com/en-us/azure/devops/repos/git/branch-policies?view=azure-devops&tabs=browser#check-for-comment-resolution
Comments NOTHING